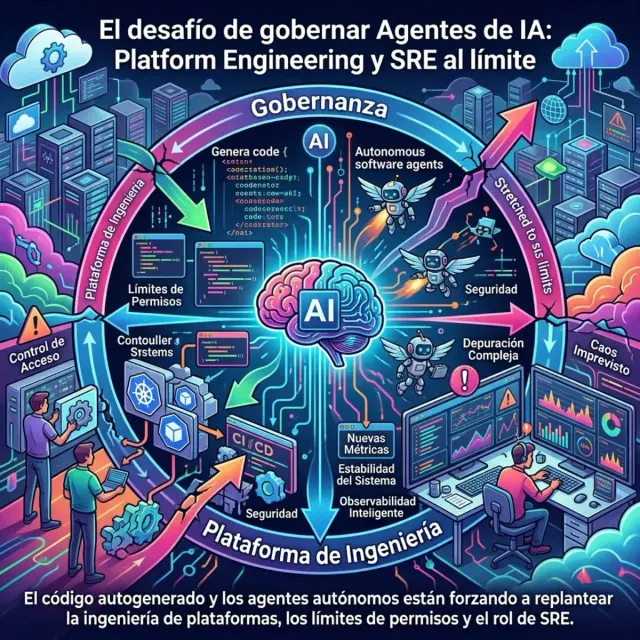
La automatización de operaciones es el Santo Grial de DevOps y SRE (Site Reliability Engineering). Sin embargo, un reciente artículo de la Cloud Native Computing Foundation (CNCF) plantea un desafío fundamental en los sistemas distribuidos modernos al que han llamado el ‘Problema de los 4 cuerpos de SRE’.
El Caos sin Contexto
La premisa es sencilla pero caótica: Imagina que un commit cambia el código de un microservicio, Terraform despliega nueva infraestructura, Kubernetes realiza un rollout de la nueva versión, y simultáneamente OpenTelemetry empieza a reportar un aumento drástico en la latencia, quemando tu presupuesto de errores (SLO).
¿Cuál fue la causa raíz? Si las herramientas operan de forma aislada (cada una automatizando su parcela), la recuperación automática (auto-remediation) suele tomar decisiones equivocadas, como escalar pods de Kubernetes de manera infinita por un problema que realmente introdujo un cambio de Terraform en la base de datos.
La Solución: Operaciones basadas en Contexto
La CNCF establece que las operaciones autónomas no pueden depender de métricas aisladas. El futuro de la observabilidad y el SRE requiere unificar:
- Eventos de Cambio: (GitOps, CI/CD).
- Topología de Infraestructura: (El estado real de Kubernetes y Cloud).
- Telemetría: (Métricas, Logs, Trazas de OpenTelemetry).
- Impacto de Negocio: (SLOs en Prometheus).
Solo cuando las herramientas de automatización pueden ingerir el contexto completo (los 4 cuerpos interactuando simultáneamente), podremos tener sistemas autónomos que no rompan producción al intentar ‘arreglarla’.
Fuentes / Referencias: