AWS anunció hoy Amazon SageMaker HyperPod Inference Gateway, un sistema de enrutamiento Kubernetes-native y GPU-aware para servir modelos de lenguaje a escala. Se instala como un add-on administrado sobre Amazon EKS, reutilizando la infraestructura HyperPod que ya tengas corriendo.
El problema de fondo
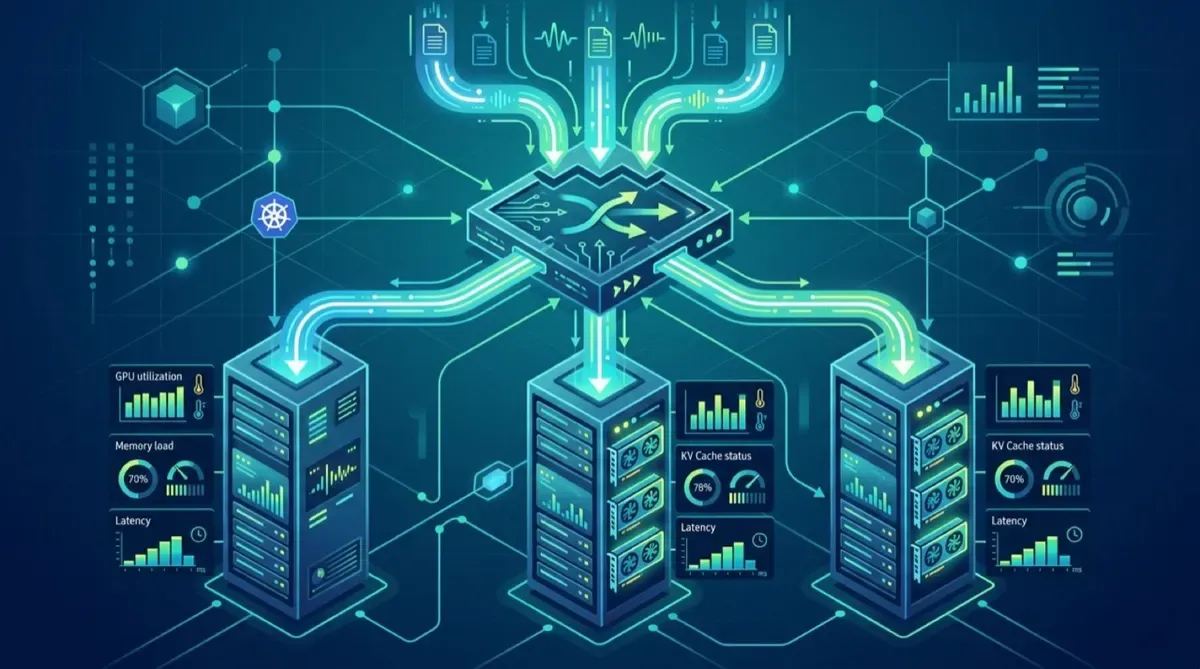
El balanceador de carga por defecto de Kubernetes (round-robin o least-connections) no tiene idea del estado real de las GPU: no sabe qué pods tienen el KV cache saturado, cuáles están a mitad de una generación de contexto largo, ni cuáles ya tienen cargado el adaptador LoRA que necesita tu request.
Resultado: las solicitudes se encolan detrás de pods ocupados mientras queda capacidad ociosa, la latencia del primer token se dispara por sobre los cuatro segundos en ráfagas de tráfico, y los equipos terminan sobre-provisionando “por si acaso”.
AWS ilustra el impacto con un caso concreto: un usuario de chatbot que esperaba 4.4 segundos por el primer token ahora lo recibe en menos de 800 milisegundos. En total, el gateway puede reducir la latencia del primer token hasta en un 82%.
Arquitectura en dos capas
El gateway usa primitivas nativas de Kubernetes y una arquitectura de dos niveles:
- Tier 1: se instala como add-on
amazon-sagemaker-hyperpod-inferenceen cada clúster HyperPod o EKS. Incluye Envoy Gateway (proxy L7 que termina el tráfico HTTPS y expone un endpoint privado por clúster), un Body-Based Router que inspecciona el body OpenAI-compatible, extrae el campomodely enruta al pool correcto (un solo gateway, múltiples modelos), y el Endpoint Picker. - Endpoint Picker: consume métricas Prometheus en tiempo real de cada pod de serving y aplica un scoring ponderado sobre KV cache utilization, queue depth, residencia de adaptadores LoRA, hit rate de prefix cache y requests en curso. Cada scorer tiene un peso configurable, así puedes afinar el enrutamiento para latencia (chat) o throughput (batch).
Todo está construido sobre la extensión open-source Gateway API Inference Extension, lo que mantiene la puerta abierta a la portabilidad y a no quedar atado a una implementación cerrada.
Por qué importa
Esto apunta directo al cuello de botella que separa “tengo un clúster con GPU” de “estoy sirviendo LLMs de forma eficiente”. Al exponer el estado real de la GPU al plano de enrutamiento, AWS ataca la sobre-provisión y la latencia de cola, dos de los dolores más caros en inferencia a escala.
Si ya estás en EKS + HyperPod, es básicamente un add-on más. La pega fina está en cómo calibrar los pesos de los scorers para tu carga particular.