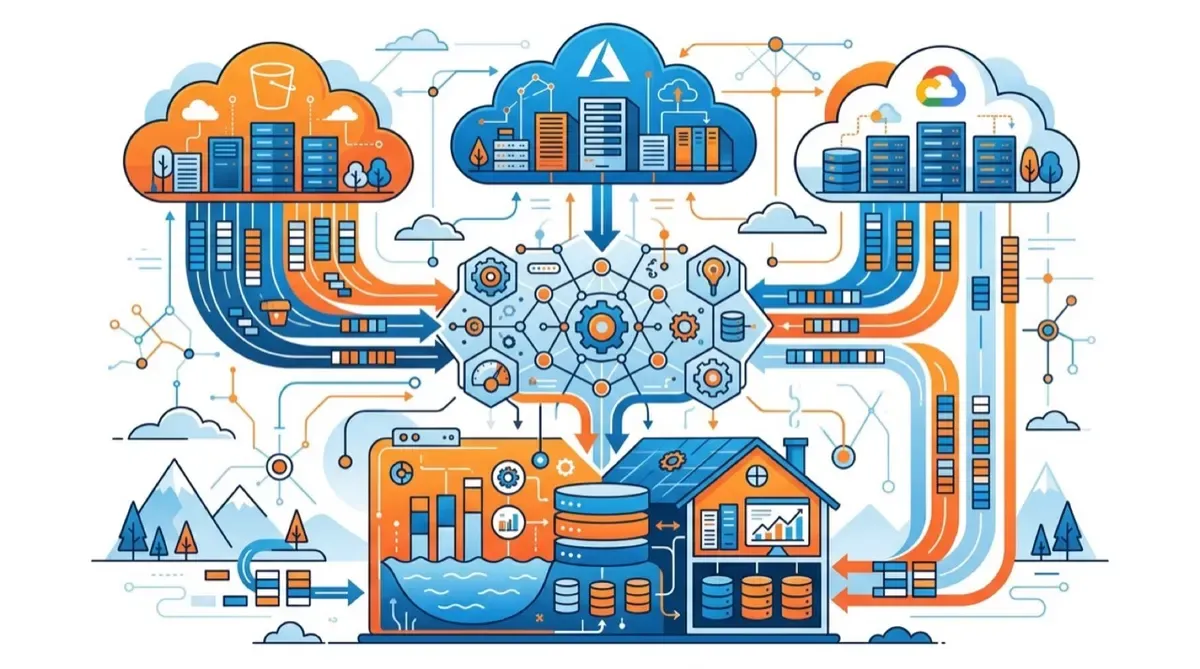
Consultar datos que viven en otra nube siempre fue caro: o los duplicabas, o pagabas transferencia por cada query. Google Cloud acaba de dar un paso grande para que eso deje de ser así, con dos features nuevas en preview para el borderless Lakehouse.
Cross-cloud caching
La idea es simple: en vez de mover archivos gigantes cada vez, BigQuery cachea localmente a nivel de sub-bloque de archivo (columnar, tipo Parquet). En un cache miss trae solo las columnas y páginas que el query proyecta; en las siguientes consultas sirve desde el caché local.
El número que más llama la atención: combinando compresión Iceberg (zstd) con el caché, muchas veces transfieres menos del 5% de los datos que procesas entre nubes. En el ejemplo que dan, un query contra 10 TiB en S3 termina moviendo 24.1 GiB la primera vez y solo 1.33 GiB en consultas siguientes (94.8% de cache hit).
Todo con encriptación en reposo por defecto, aislamiento por tenant y región, y checks de frescura para no leer datos stale.
Conexiones cross-cloud
Junto con el caché, llega el preview de BigQuery cross-cloud connections para consultar archivos sueltos (CSV, JSON, Parquet ad-hoc) en S3 y Azure Storage sin catálogo Iceberg. La regla: si tienes Iceberg federado (Unity Catalog, AWS Glue, Snowflake Horizon) usas catalog federation; si son archivos crudos, cross-cloud connections.
El objetivo de fondo es uno solo: que los agentes y analistas consulten datos gobernados donde viven, sin ETL frágil ni costos de transferencia que matan el caso de negocio.
Fuente: cloud.google.com.