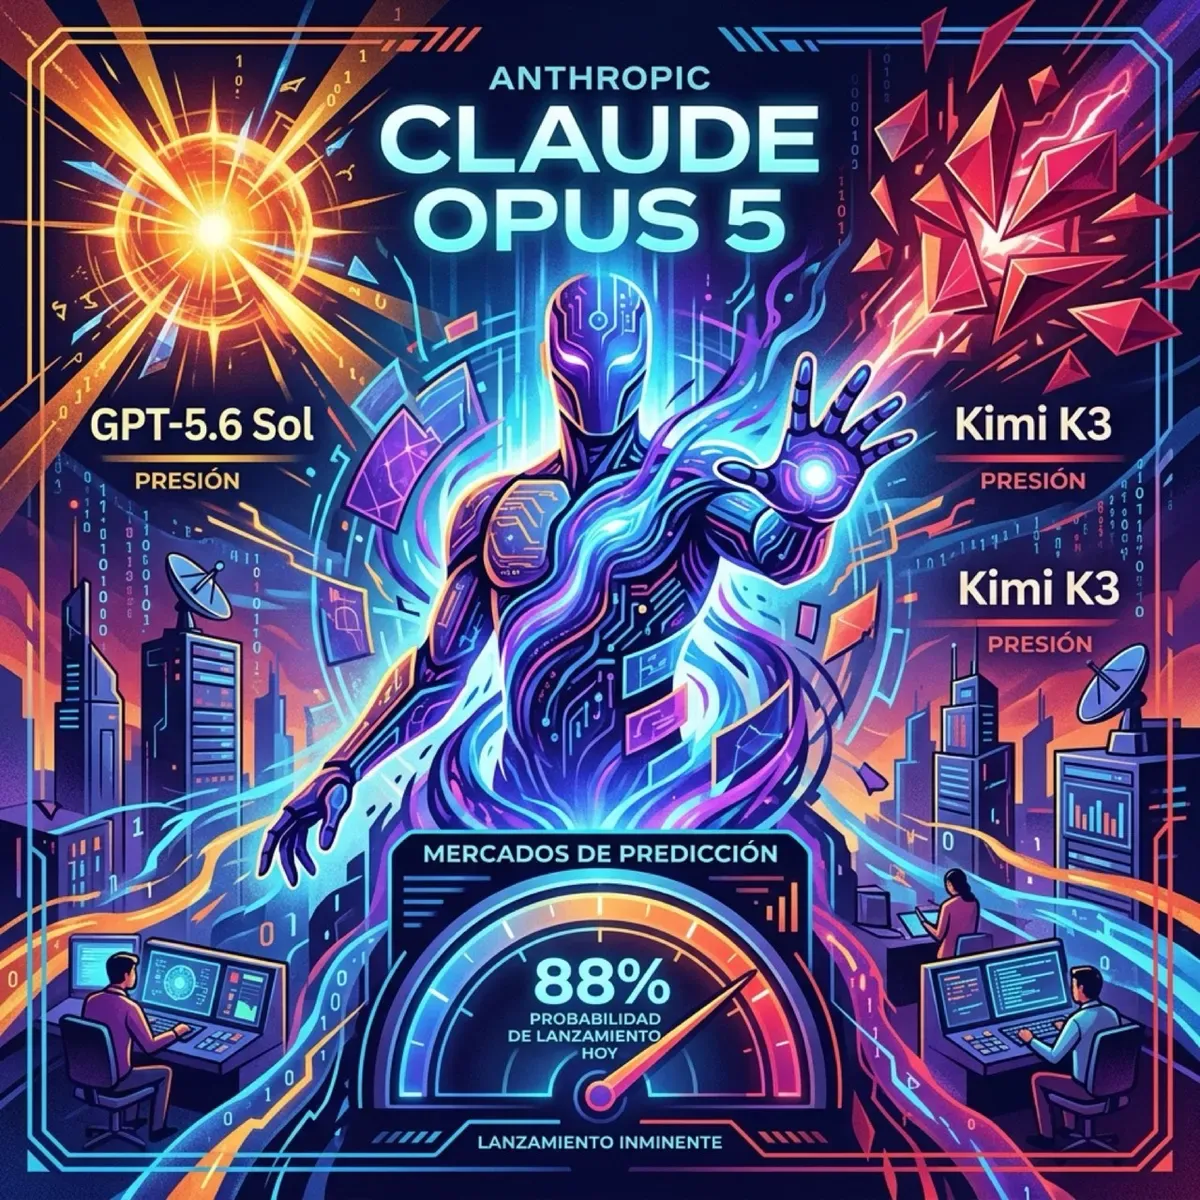
La carrera de modelos de IA entra en otra fase decisiva. Según Polymarket, la probabilidad de que Anthropic lance Claude Opus 5 este 23 de julio llegó al 88%, y ya hay señales concretas: socios de Anthropic están preparando integraciones, y se han detectado despliegues preliminares en algunos proveedores.
El contexto competitivo
El Opus 4.8 actual — lanzado el 28 de mayo — mantiene un pricing de $5 por millón de tokens de entrada y $25 por millón de salida. Eso ya es una reducción de dos tercios vs el Opus 4 original ($15/$75). Pero el precio por token ya no es la métrica que importa: lo que cuenta es el costo total por tarea.
Acá es donde se pone interesante:
- GPT-5.6 Sol (OpenAI, 9 julio) supera al Claude Fable 5 de Anthropic por 11.4 puntos en evaluaciones internas de OpenAI, usando solo configuración de razonamiento medio, y a un cuarto del costo.
- Kimi K3 (Moonshot AI, 16 julio) — 2.8 trillones de parámetros, contexto de 1M de tokens — cuesta la mitad que GPT-5.6 Sol, pero consume más tokens por respuesta, así que el ahorro real por tarea es marginal ($0.94 vs $1.04).
- Fable 5 cuesta $2.75 por tarea en promedio. Caro frente a la competencia.
¿Qué necesita Opus 5 para ganar?
No basta con ser el más inteligente. Los reportes de campo sobre Opus 4.8 destacan su eficiencia (menos pasos, mejor uso de tools), pero también señalan problemas de estabilidad. Si Opus 5 corrige eso, el costo operativo por tarea podría bajar significativamente incluso sin reducir el precio por token.
Los modelos chinos ya no son la alternativa barata — están a 2-3 puntos de los top models en benchmarks (Kimi K3: 57 vs Fable 5: 60 vs GPT-5.6 Sol: 59 en el Artificial Analysis Intelligence Index). La guerra ya no es solo de performance, sino de TCO y ecosistema.
Datos clave
| Modelo | Params | Contexto | Precio Input (por 1M) | AAII Score |
|---|---|---|---|---|
| Opus 4.8 | ~ | 1M tokens | $5 | ~58 |
| GPT-5.6 Sol | ~ | ~ | $5 | 59 |
| Kimi K3 | 2.8T | 1M tokens | $3 | 57 |
| Fable 5 | ~ | 1M tokens | ~ | 60 |
La pregunta clave: ¿podrá Opus 5 justificar su premium en un mercado donde la competencia cierra la brecha semana a semana?
Update: 24 julio 2026 — Lanzamiento esperado hoy (jueves)
Las señales se multiplicaron durante la noche. TestingCatalog reportó preparativos entre socios de Anthropic, y múltiples fuentes indican que el lanzamiento de Claude Opus 5 está agendado para hoy jueves 24 de julio.
Lo que se sabe hasta ahora:
- Performance comparable a Fable 5, pero NO se espera que lo supere en benchmarks. El foco estaría en confiabilidad, usabilidad y deployment enterprise.
- Esto tiene sentido: Fable 5 es el modelo top de la línea Mythos. Opus 5 sería el upgrade natural del 4.8, no un reemplazo de Fable.
- Si el patrón de precios se mantiene, Opus 5 podría ubicarse entre Sonnet 5 ($2/$10 intro) y Fable 5 ($10/$50).
El lanzamiento llega en el peor/buen momento para Anthropic: Altman acaba de desafiarlos a bajar precios, los modelos chinos siguen mejorando, y sus valoraciones privadas se desinflan (Anthropic bajó de US$1.79T a US$1.56T en IG esta semana).
Fuentes adicionales: TheWinCentral, TestingCatalog, Digg
Update: 24 julio 2026 — ¡OFICIAL! Claude Opus 5 disponible desde hoy
Anthropic confirmó el lanzamiento oficial de Claude Opus 5 este viernes. Acá van los datos concretos:
Performance y pricing:
- Casi alcanza a Fable 5 en benchmarks, pero a la mitad del precio
- Pricing igual a Opus 4.8: $5 input / $25 output por millón de tokens
- Fast mode disponible: 2.5x velocidad al doble de precio
- Es el nuevo modelo default en Claude Max y el más potente en Claude Pro
La killer feature: effort toggle
- Los usuarios pueden elegir cuánto esfuerzo pone el modelo: low, medium o high
- Esto permite balancear costo vs. capacidad por tarea
- En el contexto de la guerra de precios con OpenAI y modelos chinos, esto es clave — pagas por lo que necesitas, no más
Mejoras concretas vs Opus 4.8:
- Mejor verificación de su propio trabajo y recuperación de errores sin intervención
- Más capaz en coding agéntico, resolución de problemas novedosos y razonamiento multidisciplinario
- El modelo más capaz para investigación científica disponible públicamente, con fuerza particular en biología
- Mejor generación de outputs visuales
Seguridad:
- Guardrails similares a Opus 4.8 en la mayoría de áreas, pero más fuertes en ciberseguridad
- Cuando Opus 5 rechaza una petición por safety, la API hace fallback automático a otro modelo — el usuario siempre gets an answer
- Anthropic lo llama “el modelo Opus más alineado y menos susceptible a ser engañado para mal uso”
- Cerca de Mythos 5 en encontrar vulnerabilidades, pero NO entrenado para explotación
El contexto competitivo:
- Es el cuarto modelo que Anthropic lanza en menos de dos meses (Mythos 5, Fable 5, Sonnet 5, Opus 5)
- Fable 5 fue el modelo polémico que EE.UU. sometió a export controls tras el reporte de Amazon sobre bypass de safeguards
- Opus 5 resuelve el problema de burn rate de tokens que tenía Fable 5 — menos back-and-forth, más eficiencia
- Clem Delangue (CEO de Hugging Face) dijo que closed model APIs rechazan “mucho trabajo legítimo de seguridad porque analizar un ataque se parece mucho a preparar uno”
La jugada es clara: Anthropic necesita un modelo que sea suficientemente capaz para uso diario enterprise, con costos controlables, y que no asuste a los reguladores. Opus 5 pinta como ese sweet spot.
Fuentes: Fortune, MacRumors, Anthropic, Bloomberg, 9to5Mac
Update: 25 julio 2026 — Benchmarks completos y el eje que define 2026
Ya con los datos completos de benchmarks terceros, el panorama de Opus 5 es más claro — y más interesante de lo que parecía:
Los números que importan:
- Frontier-Bench v0.1 (coding agéntico en terminal): Opus 5 logra 43.3%, más del doble que Opus 4.8 (18.7%) y supera claramente a Fable 5 (33.7%) y GPT-5.6 Sol (34.4%)
- ARC-AGI-3 (resolución novedosa de problemas): 30.2% — casi 4 veces más que GPT-5.6 Sol (7.8%). Acá no hay número de Fable 5 todavía, pero el salto es obsceno
- GDPval-AA v2 (knowledge work): Elo 1,861, por encima de Fable 5 (1,747) y GPT-5.6 Sol (1,736)
- OSWorld 2.0 (computer use): supera el mejor resultado de Fable 5 a un tercio del costo
- DeepSWE v1.1: Acá GPT-5.6 Sol sigue liderando con 72.7%, vs Opus 5 en 68.8% y Fable 5 en 69.7%
El paradoja del effort max: Opus 5 tiene cinco niveles de effort: low, medium, high, xhigh y max. Anthropic recomienda “xhigh” para coding agéntico. ¿El detalle? En max effort el modelo rinde levemente peor que en xhigh en dos benchmarks (Frontier-Bench y AA Coding Agent Index), a pesar de costar más. Es un hallazgo interesante — sugiere que hay un punto de returns decrecientes en el razonamiento extendido.
Eficiencia real (no solo precio por token): Los早期 usuarios reportan datos concretos:
- Harvey (legal AI): misma performance que Opus 4.8 en max-reasoning, pero con 26% menos tokens
- Fundamental Research Lab: +9 puntos de accuracy en financial modeling, usando 60% menos tiempo y un tercio menos de tool calls
- Zapier: Opus 5 logró 100% en su AutomationBench — ningún modelo anterior lo había pasado
- Cognition (Devin): “approaches Fable-level performance at half the cost” en FrontierCode 1.1
La framing que importa: Anthropic está vendiendo una distinción sutil pero clave: tareas acotadas vs. autonomía de larga duración. Opus 5 es el mejor para jobs que un benchmark puede medir. Fable 5 es para cuando el trabajo se extiende por horas o días con material denso. Esa puede ser la dimensión que defina la diferenciación de modelos en 2026 — no quién es más inteligente, sino quién dura más coherente.
Fuentes: VentureBeat, The Decoder, BenchLM, Artificial Analysis