El dilema llevaba años enredado: los gigantes usan crawlers de doble uso — un mismo bot sirve para búsqueda Y para entrenamiento de IA. Bloquear uno era bloquear ambos: o alimentabas el modelo o desaparecías de Google. Cloudflare acaba de romper esa disyuntiva con el nuevo ajuste Disallow AI Training: sigues indexado en búsqueda, pero ese mismo crawler no puede entrenar contigo. Apple, Google y Microsoft ya lo respetan o se comprometieron a respetarlo en plazo definido.
El dato que lo justifica
Los números de Cloudflare son elocuentes: menos del 1% de los sitios bloquea bots de búsqueda, pero un 17% ya activa algún mecanismo para bloquear el entrenamiento. La gente quiere ser encontrada; no quiere ser corpus gratuito.
Por qué robots.txt no alcanza
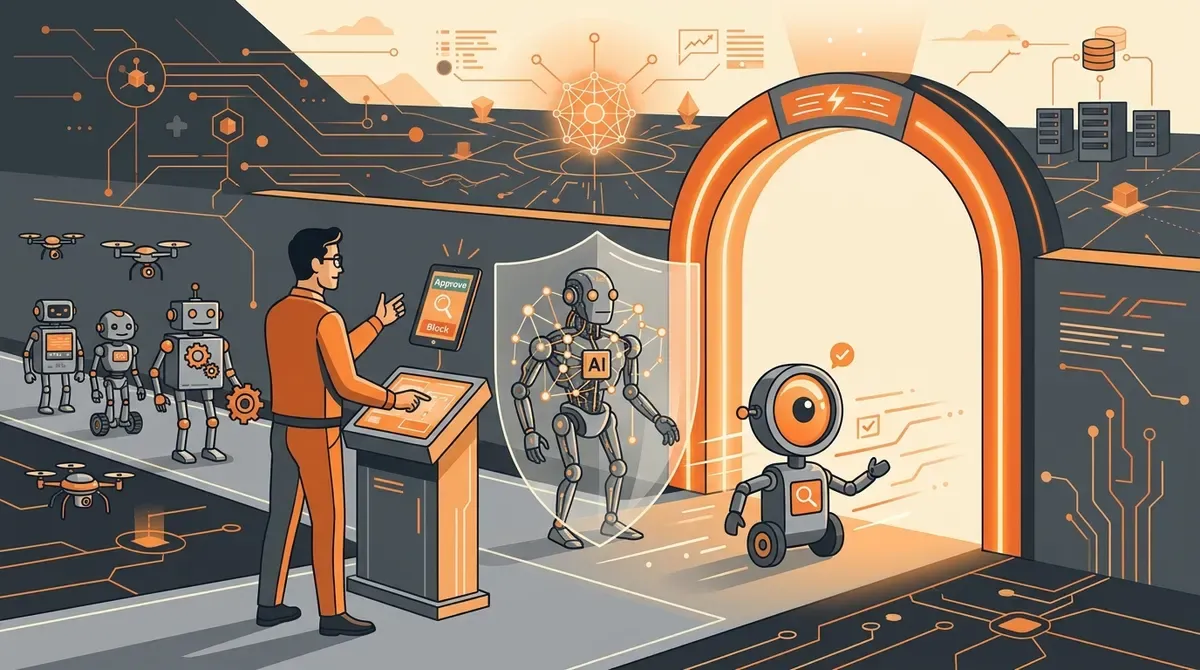
Un archivo robots.txt no identifica quién está rastreando, no sabe para qué, y no puede detener a quien lo ignora. Una red sí puede: Cloudflare publica la preferencia del sitio, identifica quién rastrea, clasifica con qué propósito, bloquea al que la ignora y reporta qué hace cada operador en Radar. La diferencia entre declarar una intención y poder hacerla cumplir.
La designación “Accountable”
Para distinguir a los operadores que juegan limpio, Cloudflare creó el sello Accountable, que exige (hoy o con compromiso concreto y con plazo):
- Mecanismo de opt-out de entrenamiento vía robots.txt o estándar similar
- Opt-out de resúmenes de IA (AI summaries) configurable con el operador
- Visibilidad a nivel de URL de qué páginas se usaron para entrenar, más métricas de cómo apareció el contenido en búsqueda
- Garantía de que optar out del entrenamiento no afecta los resultados de búsqueda tradicionales
Apple, Google y Microsoft cumplen o comprometieron. Los demás ya saben dónde queda la vara.
Lo que viene
El siguiente frente son los AI summaries: un sí o no a nivel de sitio es demasiado burdo — importa cuánto de tu contenido aparece en un resumen. Para comienzos del próximo año, Cloudflare apunta a dejarte controlar cuánto contenido se incluye, configurado una sola vez y aplicado a todos los operadores soportados.
Después del Content Independence Day de julio, esto consolida la postura: la default de la web no es “todo disponible para entrenar”. Y por primera vez, los grandes buscadores no pueden responder con un “tómalo o déjalo”.