Si tienes servidores Linux, nodos de Kubernetes o cualquier cosa que use ipset para manejar reglas de firewall, atención: CVE-2026-64189 puede tirarte un kernel panic con tareas de rutina.
El bug
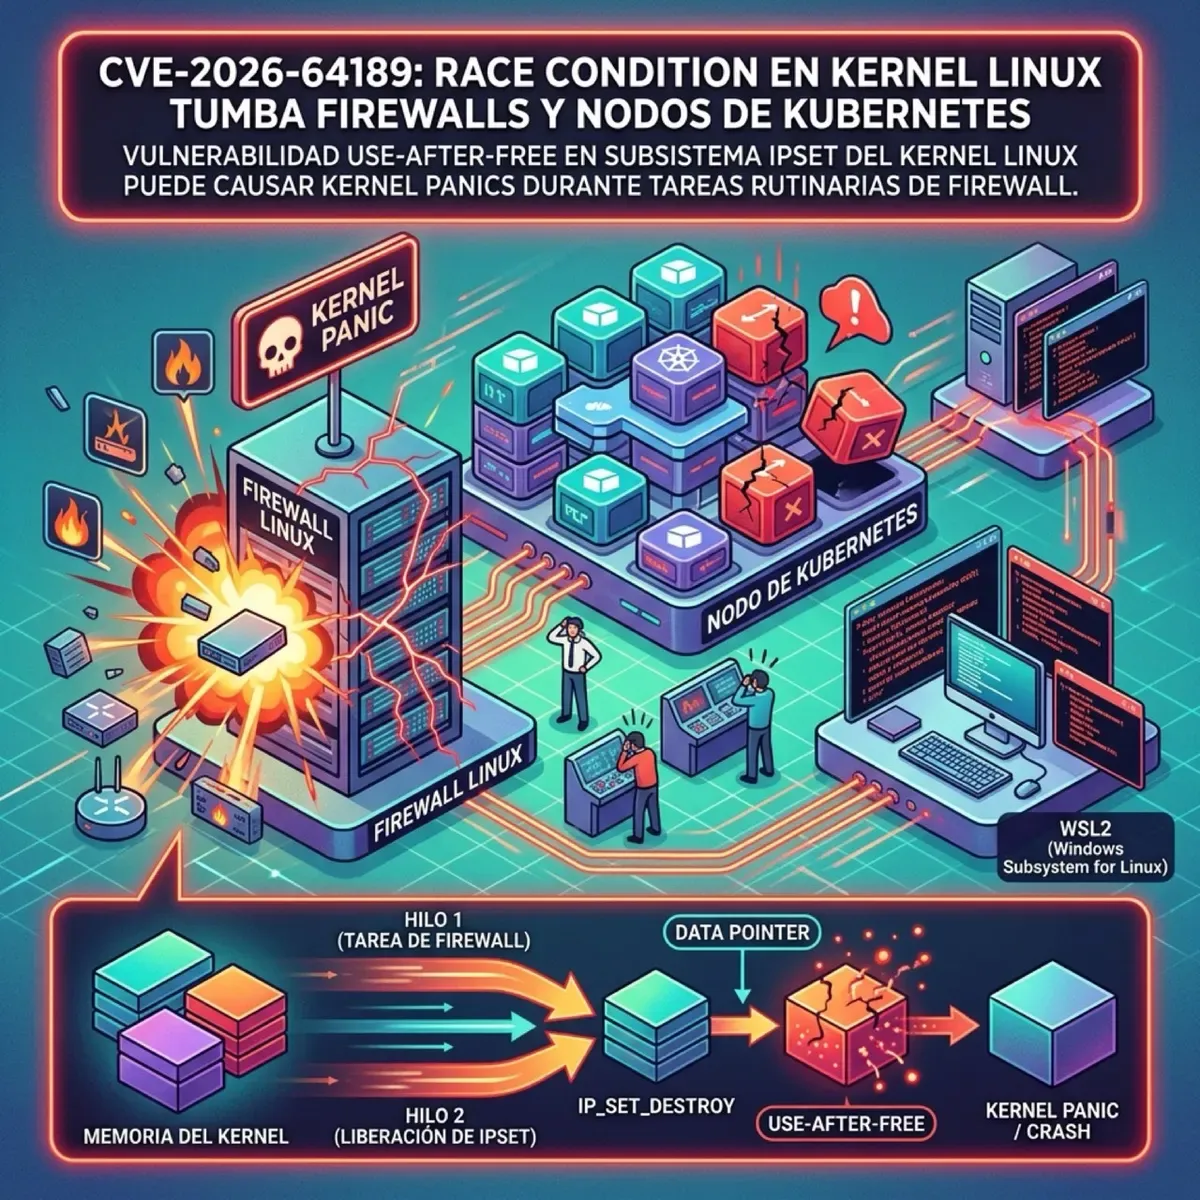
Es un use-after-free en el subsistema ipset de netfilter, en el kernel Linux. Publicado el 20 de julio.
El problema es una race condition: cuando un administrador hace un “dump” del contenido de IP sets (para monitoreo o troubleshooting) al mismo tiempo que otra operación hace resize del array interno, la memoria se corrompe. El dump lee un array de punteros sin la sincronización RCU adecuada, y mientras tanto ip_set_create() puede estar liberando ese mismo array.
Resultado: slab-use-after-free → general protection fault → kernel panic.
Está presente desde la versión 4.20 del kernel (y 4.19.5). O sea, lleva años ahí.
Quién está en la zona de impacto
- Servidores Linux y gateways que usan iptables/nftables con IP sets para blocklists dinámicas, filtrado geográfico o feeds de threat intelligence
- Nodos de Kubernetes y hosts de contenedores donde network policies, service meshes o agentes de seguridad manipulan IP sets (incluye Calico, Cilium y Flannel)
- Appliances virtuales e instancias cloud de vendors que embedean automatización de firewall
- WSL2 en Windows: si corres Docker o VPN clients con custom networking, estás expuesto
- VMs Linux en Hyper-V o VMware: el host no se ve afectado directamente, pero el guest necesita parcheo
El escenario real
Imagina esto: tu equipo de SecOps carga un feed de IPs maliciosas en un ipset cada 5 minutos. Un sistema de monitoreo separado pollea el estado del firewall cada minuto para verificar compliance. Ninguna de las dos acciones es inusual, pero cuando el resize y el dump coinciden → kernel panic, sistema caído, conexiones perdidas, VPN tunnels dropeados.
No es explotable remotamente por un atacante sin autenticación. Necesita privilegios (típicamente CAP_NET_ADMIN), pero en entornos multi-tenant o con automatización constante, la probabilidad de触发 la race condition sube considerablemente.
Qué hacer
- Parchear el kernel lo antes posible. Las distros principales ya tienen o tendrán los patches disponibles.
- Si no puedes parchear inmediatamente, reduce la frecuencia de operaciones simultáneas de dump y creación/resize de ipsets. Stagerea las actualizaciones de threat feeds y los scans de compliance.
- Revisa plataformas de contenedores: sigue los advisories de Calico, Cilium y Flannel respecto a requisitos de kernel.
- Para WSL2: actualiza el kernel de WSL desde Microsoft o tu distro.
💡 Por qué importa: Este bug es un ejemplo de libro de texto de cómo errores sutiles de sincronización pueden lurkar en código fundamental del kernel durante años. No es un zero-day sexy con exploit remoto — es un bug de concurrencia en código que se usa a diario en infraestructura crítica. Los peores incidentes casi siempre vienen de lugares aburridos.