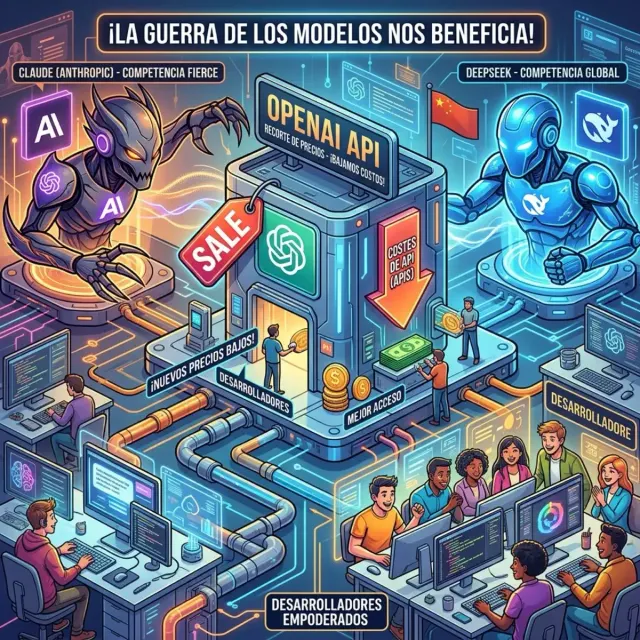
Ya lo veníamos venir. DeepSeek lanzó V4 Flash el 31 de julio y los números son una bofetada para la industria: $0.14 por millón de tokens de input, $0.28 de output. Para ponerlo en perspectiva, lo que te cuesta $25 en Anthropic Opus 4.8 te cuesta 28 centavos en DeepSeek. Un 99% de descuento.
Los datos
DeepSeek V4 Flash debuted en el leaderboard de Arena.ai para coding front-end por encima de Opus 4.8 — o sea, no es solo barato, es competitivo en benchmarks reales.
| Modelo | Input (por 1M tokens) | Output (por 1M tokens) | Contexto |
|---|---|---|---|
| DeepSeek V4 Flash | $0.14 | $0.28 | 1M |
| DeepSeek V4 Pro | TBD (agosto) | TBD | 1M |
| Anthropic Opus 4.8 | ~$15 | ~$75 | 200K |
| OpenAI GPT-5.6 | ~$5 | ~$15 | 256K |
El pricing blended de DeepSeek (7:2:1 cache hit/input/output) sale a $0.06 por millón de tokens. Es literalmente gratis comparado con cualquier alternativa gringa.
El upgrade agentic
V4 Flash no es solo otro modelo barato. DeepSeek habilitó la Responses API (similar a la de OpenAI) que soporta tool use nativo, function calling y workflows agénticos. El modelo está diseñado específicamente para:
- Asistentes de coding
- Sistemas de chat
- Agent workflows donde responsividad y costo importan
V4 Pro (el modelo más capaz) todavía no tiene soporte en la Responses API, pero DeepSeek confirmó que llegará a principios de agosto.
La carrera a cero
Axios bautizó el fenómeno perfecto: “AI’s race to zero”. Lo que estamos viendo:
- Modelos chinos igualando performance frontier a fracción del costo. Kimi K3, DeepSeek V4 Flash, LongCat-2.0 de Meituan — todos compitiendo en el mismo ballpark que OpenAI/Anthropic pero con estructuras de costos radicalmente menores.
- OpenAI recortando precios la semana pasada para retener developers.
- Anthropic acusando a DeepSeek (febrero 2026) de usar miles de cuentas fraudulentas para generar millones de conversaciones con Claude y entrenar sus propios modelos.
- Microsoft desarrollando su familia MAI y chips Maya 200 para reducir dependencia de OpenAI.
¿Qué significa para tu stack?
- Si estás pagando $15+ por millón de tokens, estás pagando demasiado. Salvo que necesites capacidades muy específicas de Opus/GPT-5.6, DeepSeek V4 Flash cubre el 90% de los use cases a 1% del costo.
- Model routing deja de ser opcional. La estrategia de usar modelos diferentes según el task (DeepSeek para tareas rutinarias, Opus/GPT para razonamiento complejo) es la única arquitectura que hace sentido económico.
- El costo de IA tiende a cero. Cada release china empuja los precios hacia abajo. Construye tu arquitectura asumiendo que el próximo modelo será más barato, no más caro.
- La soberanía de datos es la única barrera real. Si tu empresa no puede mandar datos a China por compliance, vas a seguir pagando premium por modelos occidentales. Esa es la única razón de peso.
La pregunta ya no es si los modelos chinos van a alcanzar a los gringos — ya lo hicieron. La pregunta es cuánto tiempo más los laboratorios occidentales pueden justificar sus precios antes de que el mercado se vaya completo.
Update: 3 de agosto — Artificial Analysis publica benchmarks completos y Alibaba lanza Qwen3.8-Max
Hoy Reuters publicó datos de Artificial Analysis que ponen los números en perspectiva real. No es solo que DeepSeek sea barato por token: es barato por tarea completa. La firma calculó el costo promedio por evaluación:
| Modelo | Costo promedio por tarea | Intelligence Index (0-100) |
|---|---|---|
| DeepSeek V4-Flash | $0.03 | 50 |
| Kimi K3 (Moonshot) | $0.86 | 57 |
| GPT-5.6 Sol (OpenAI) | $1.86 | ~59+ |
| Claude Fable 5 (Anthropic) | $3.15 | ~59+ |
| Gemini 3.6 Flash (Google) | — | 50 |
| GLM-5.2 (Z.AI/Zhipu) | — | 51 |
El dato brutal: V4-Flash cuesta 100 veces menos por tarea que Claude Fable 5. Y empata en intelligence index con Gemini 3.6 Flash de Google.
Claro, los modelos frontier (Opus 5, Fable 5, GPT-5.6) siguen siendo 9+ puntos más altos en el Intelligence Index. Si necesitas razonamiento de élite, DeepSeek no está ahí todavía. Pero para el 80% de los use cases (coding rutina, chat, extracción, tool use), el score de 50 es perfectamente usable.
Lo otro que pasó hoy: Alibaba lanzó Qwen3.8-Max, su modelo más grande y capaz hasta la fecha, compitiendo directamente con Kimi K3 de Moonshot en tamaño. La carrera china no se desacelera — se acelera.
DeepSeek también estaría preparando una potencial IPO según fuentes de Reuters, y tiene V4-Pro en camino (sin fecha confirmada todavía).
La conclusión se refuerza: la carrera a cero no es una anécdota, es la tendencia estructural de 2026. Construye tu arquitectura asumiendo que cada trimestre habrá un modelo más barato y competitivo.
Fuentes: Axios, Artificial Analysis vía Reuters/CNA, OpenRouter, DeepSeek API Docs
Update: 7 de agosto — Se acabó la fiesta: DeepSeek anuncia alzas de precios significativas
El mercado tiene otras reglas y la empresa china acaba de golpear los frenos. Según reportes de Bloomberg y confirmaciones a desarrolladores, DeepSeek anunció que implementará un aumento “significativo” en los precios de todos sus servicios API.
Aunque aún no han dado fecha exacta ni el porcentaje del alza, el aviso de que el salto será “sustancial” cambia por completo la estrategia de quienes estaban migrando workloads pesados a sus modelos para aprovechar el costo casi cero. Las posibles razones van desde problemas para sostener los costos de infraestructura (Capex), un esfuerzo por controlar la abrumadora demanda, hasta preparativos para mostrar mejores márgenes antes de una posible IPO.
Esto le da un respiro a gigantes como OpenAI y Anthropic, que la semana pasada habían reaccionado bajando precios. La carrera a cero acaba de tropezar con la realidad financiera.