El scraping dejó de ser un script sucio en Python para convertirse en la capa de entrada de datos de los agentes de IA. Y Firecrawl acaba de levantar una ronda grande para dominar ese espacio.
Los números
- $75 millones en Serie B, liderada por Smash Ventures.
- Participan Y Combinator, Altos Ventures, Nexus Venture Partners, Freestyle y Offline Ventures.
- Base: Los Angeles.
Qué hacen
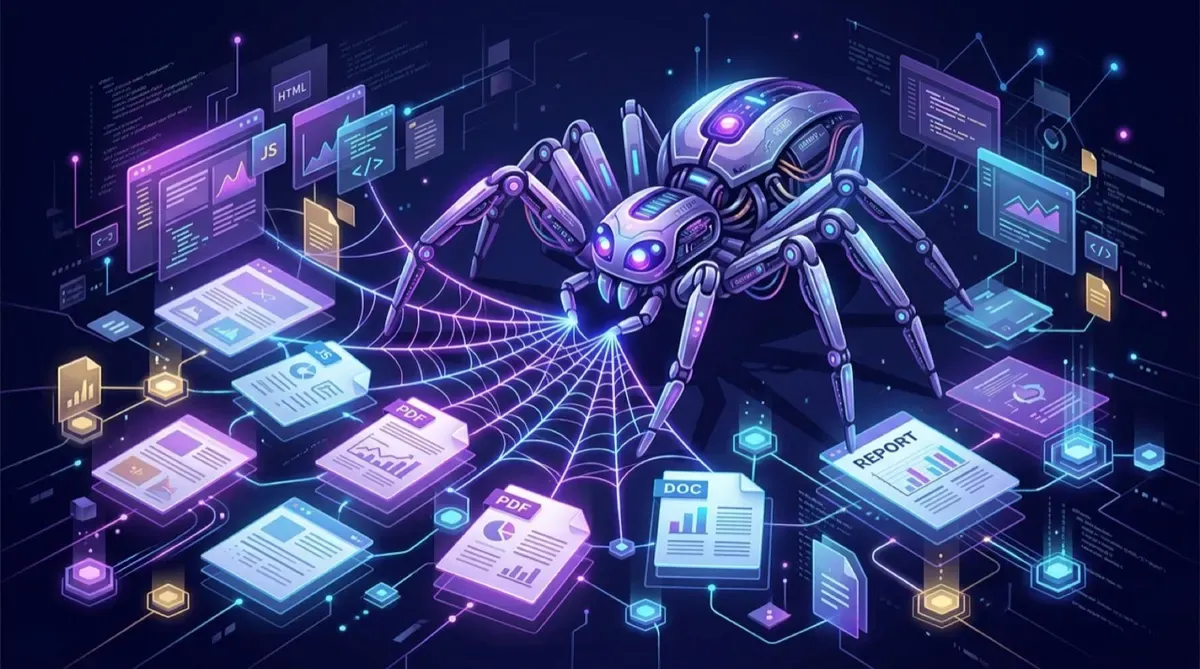
Firecrawl construyó un stack de scraping optimizado para agentes. No es el crawler de siempre: maneja cargas de página multi-fase, interacción con elementos dinámicos y extracción de PDFs y documentos. O sea, le resuelve a un agente el problema de “cómo leo y entiendo una página que no es HTML plano”.
Con los fondos, apuestan a Alexandria, su servicio de licenciamiento de datos, y a integraciones con fuentes de terceros.
Por qué importa
En la era de los agentes, la calidad de la salida depende de la calidad del input. Y el input, muchas veces, es la web. Herramientas como Firecrawl se están volviendo infraestructura invisible para la economía de agentes: sin una capa sólida de extracción de datos, los agentes alucinan o se quedan sin contexto.
Es el mismo patrón que vimos con las bases de datos y las colas: cuando una tecnología se masifica, la capa de plumbing se convierte en negocio.
La lectura
Para equipos que están armando productos con agentes, el mensaje es claro: no reinventen el scraping. Hay herramientas maduras que ya resuelven la extracción de datos de la web, y el capital fluyendo hacia ellas (Firecrawl con $75M, y el ecosistema creciendo) confirma que el problema es real y está lejos de estar resuelto.
Fuente: AI Weekly (22 sep 2026).