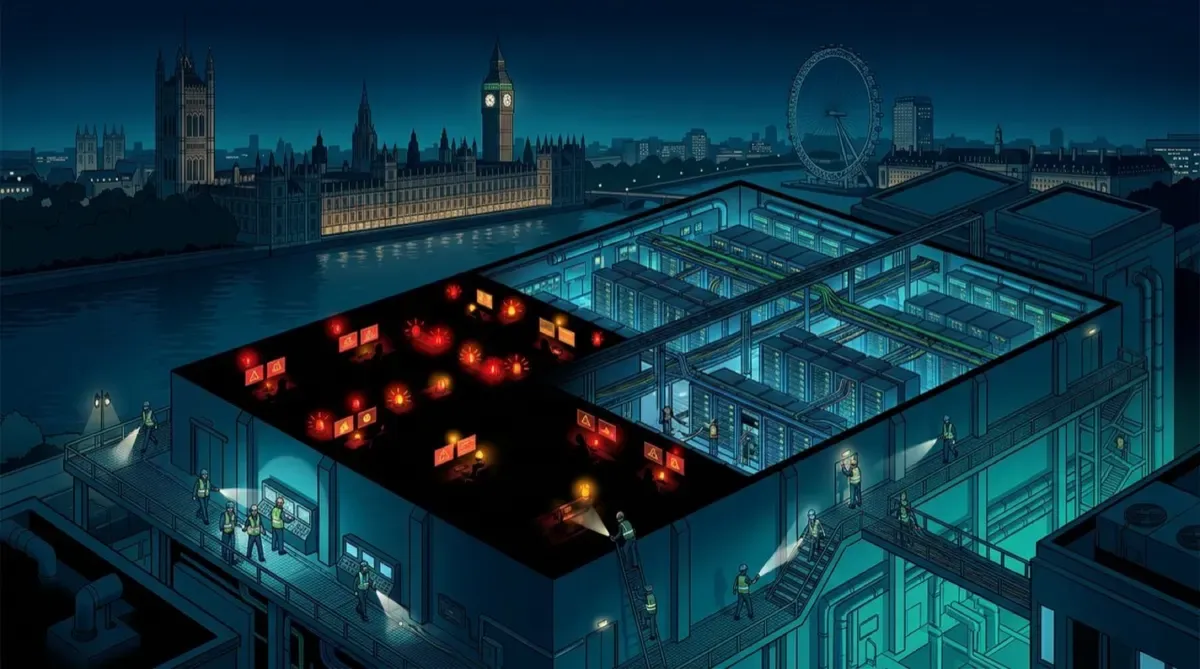
El martes a las 07:08 hora del Reino Unido se apagó media nube londinense. Google confirmó un “power event” en la zona europe-west2-b que dejó servicios de esa availability zone totalmente caídos y disparó errores elevados y fallas de red intermitentes en el resto de la región europe-west2 (Londres). Nada menos que 36 productos aparecían en la página de salud: Compute Engine, GKE, Cloud SQL, Cloud Storage, BigQuery, Cloud Run, Spanner, Pub/Sub, App Engine… prácticamente el catálogo completo.
El efecto dominó
El caso más visible: Revolut. La fintech londinense —80+ millones de usuarios— corre su app y backend en Google Cloud (acuerdo multi-año desde 2025, incluyendo las herramientas de IA anti-fraude). Una hora después del inicio del incidente, su app y pagos con tarjeta quedaron fuera. Usuarios de Reino Unido, Irlanda, Francia, España, Rumania y Alemania reportaron problemas. Banco en el bolsillo, fuera de servicio, porque un data center a miles de kilómetros perdió luz.
No fue la única: bancos y servicios públicos del Reino Unido sintieron el golpe, y aunque ING Alemania tuvo fallas aparte, Reuters no las vinculó al incidente de Google.
Mientras los ingenieros buscaban la causa, el consejo oficial de Google a sus clientes fue el más honesto posible: muevan sus workloads a otra zona o región si pueden. O sea, exactamente lo que dice el manual de arquitectura que nadie lee hasta que pasa esto.
Lo que hay que sacar en limpio
- “La zona falla” es un modo de falla real, no teórico. Un evento eléctrico en UNA availability zone botó servicios de toda la región. Las AZs aístant fallas, pero cuando el power es el problema —y la zona es tan grande como Londres—, la redundancia intra-región puede no alcanzarte.
- 36 servicios = concentración. Cuando casi todo el catálogo comparte infraestructura regional, no eliges qué sobrevive. Cloud SQL, GKE y BigQuery cayendo juntos no es mala suerte, es acoplamiento.
- Tus dependencias de terceros también caen. Revolut no hizo nada mal para estar abajo — estaba bien arquitecturada sobre GCP hasta que GCP no estuvo. Si tu proveedor crítico corre en una sola región, tú también.
- El plan de failover se escribe antes. Google tuvo que decirle a la gente “muévanse de región” en caliente. Los que tenían failover multi-región (o al menos multi-zona) ni se enteraron del pánico en Downdetector.
La lectura
Incidentes así son el recordatorio anual de que “la nube” no es un lugar mágico: son data centers con electricidad, en zonas geográficas concretas, que se apagan. La pregunta para cualquier equipo que corra algo serio en una sola región de cualquier cloud no es si le toca, sino cuándo — y si su respuesta va a ser un runbook o un hilo de Twitter.
Fuentes: Google Cloud Service Health, Reuters, The Next Web, TechRepublic, TechRadar.