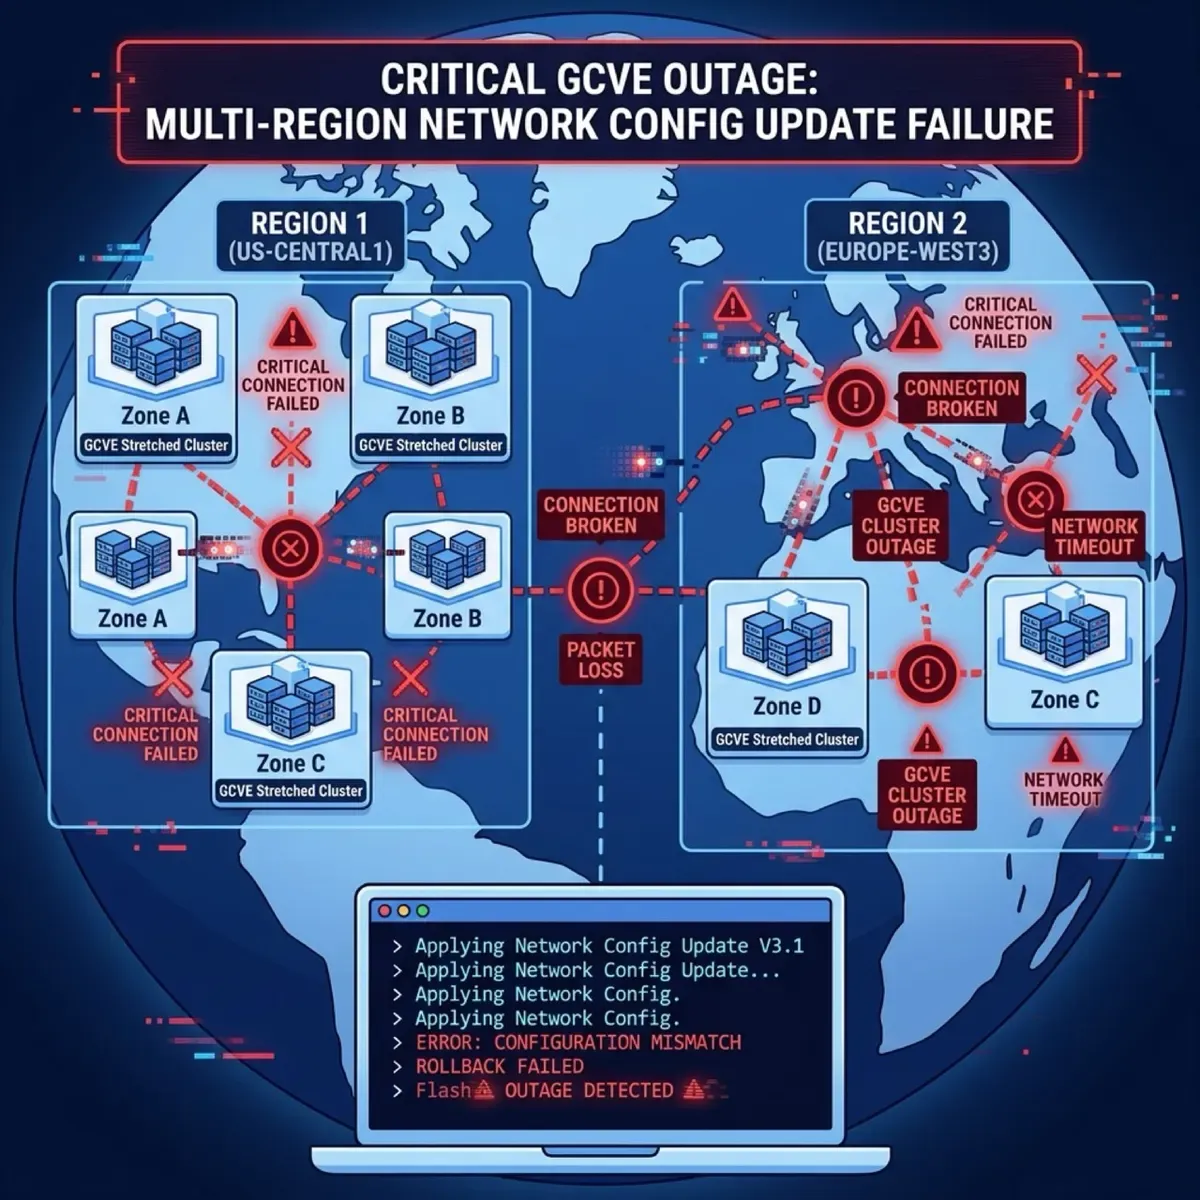
Google Cloud tuvo un incidente serio anoche. Un update de configuración de red defectuoso causó un outage de más de 10 horas en Google Cloud VMware Engine (GCVE), afectando stretched clusters en Sydney, Melbourne y Frankfurt.
Timeline del incidente
- 14 jul, 17:00 UTC — Inicio del incidente. Pérdida de conectividad inter-zone en stretched clusters
- 20:24 UTC — Google confirma el issue como problema de conectividad de red que afecta stretched clusters
- 22:30 UTC — Identifican fallos de comunicación inter-zone y BGP session flapping entre zonas. El witness appliance queda inalcanzable, las zonas no pueden sincronizar estado. VMs quedan aisladas y sin capacidad de escribir datos
- 23:05 UTC — Se identifica que un configuration update reciente es la causa probable
- 15 jul, 04:46 UTC — Mitigado haciendo rollback de la configuración a su último valor conocido
¿Qué falló?
Las VMs seguían corriendo, pero nadie podía acceder a ellas. El problema estuvo en el SDN orchestration control plane — una actualización rutinaria introdujo un routing failure que afectó múltiples zonas simultáneamente.
“While most of the physical nodes are distributed for exactly this redundancy purpose, they are still tightly coupled to a singular shared orchestration fabric, so if that control plane crashes, then everything comes crashing down.” — Neil Shah, Counterpoint Research
El punto crítico: los stretched clusters existen precisamente para sobrevivir fallas de un sitio. Cuando la red que conecta ambos sitios se cae, esa resiliencia desaparece. Las VMs estaban healthy en compute y storage, pero inalcanzables.
Lección
Esto refuerza una verdad incómoda del cloud: incluso la infraestructura managed puede fallar en componentes compartidos críticos. El control plane del SDN es un single point of failure que afecta a todas las zonas que dependen de él, sin importar cuánta redundancia física tengas.
Para los que corren workloads críticos en GCVE stretched clusters, este incidente es un recordatorio brutal de revisar tus RTO/RPO reales y no asumir que “managed cloud” significa “sin fallas”.
Fuente: Network World
Update: 21 julio 2026 — Análisis de The Register revela dependencias ocultas
The Register publicó un análisis más profundo del incidente basado en el incident report oficial de Google. Detalles clave que se confirmaron:
- La causa raíz fue una falla de energía upstream del datacenter que sirve europe-west4-a para GCVE, NetApp Volumes y Bare Metal Solutions
- Esto causó una falla de cooling y Google tuvo que apagar workloads proactivamente para proteger datos de temperaturas altas
- 15 horas de downtime total
- El detalle crítico: Google usa un datacenter discreto para esos tres servicios. No es un problema de la zona completa — fue un solo edificio el que cayó
Forrester lo planteó claro:
“Customers are generally told to use multiple zones and regions for resilience but are rarely given visibility into whether a particular managed service has a single-datacenter dependency within a zone.”
La lección mayor: los hyperscalers te dicen “usa multi-zone” pero no te avisan cuando un servicio managed depende de un solo datacenter dentro de esa zona. La abstracción del cloud te hace asumir más redundancia de la que realmente existe para servicios especializados.
Fuente update: The Register