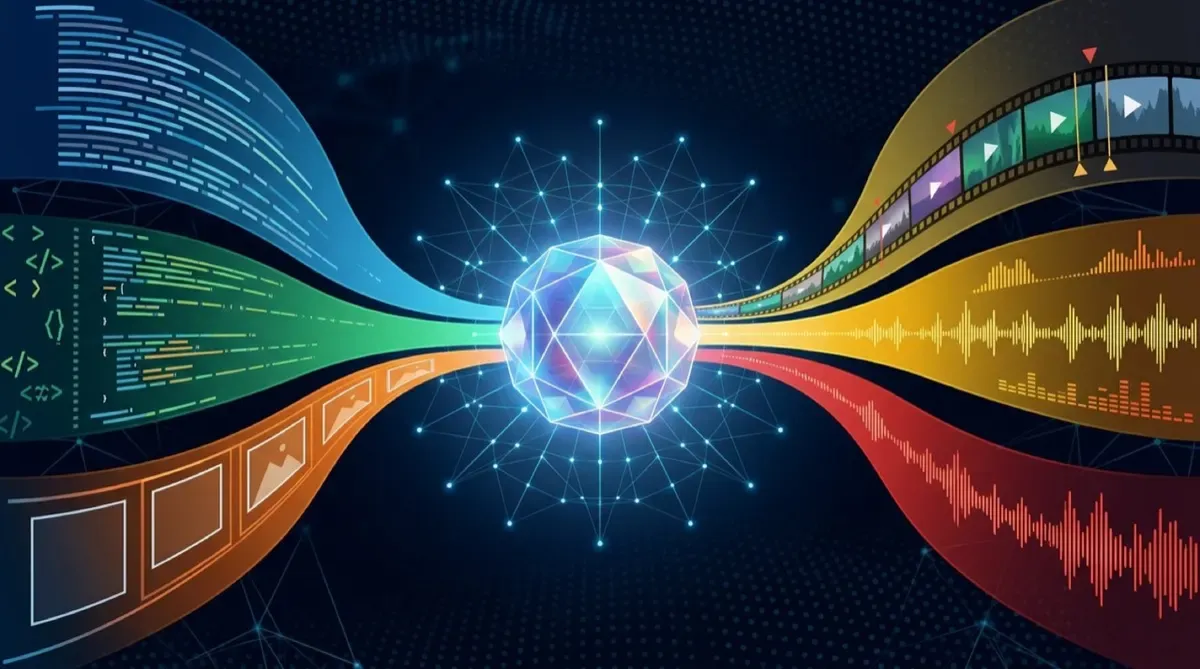
Google liberó EmbeddingGemma 2, la nueva generación de su modelo de embeddings, y esta vez la apuesta es claramente multimodal: texto, código, imágenes, video y audio viven en un mismo espacio de embeddings de 768 dimensiones, bajo licencia Apache 2.0 y con pesos abiertos en Hugging Face. Está construido sobre Gemma 4.
¿Por qué importa? Porque hasta ahora, armar búsqueda semántica multimedial significaba mantener espacios de embeddings separados e incompatibles por modalidad — uno para texto, otro para imágenes, otro para audio — y sufrir el pegamento en el medio. Con un espacio unificado, podés buscar “ese screenshot donde configuré el firewall” o “el video donde se explica el failover” y comparar todo por similitud semántica directa.
Chico, modular y para tu notebook
El diseño apunta al on-device: correr en hardware de consumo, notebooks y móviles, con baja latencia para RAG local, clasificación y clustering.
- Cargás solo lo que necesitás: desde 270 millones de parámetros (texto y código) hasta 740 millones (multimodal completo).
- En code search y recuperación técnica, Google dice que supera claramente a EmbeddingGemma 1, apuntando a indexación local de codebases y búsqueda agéntica de código.
Además soporta Matryoshka Representation Learning (MRL): los vectores se pueden truncar a dimensiones menores para ahorrar storage. Un millón de vectores de 768 dimensiones en bfloat16 ocupa ~1,5 GB; truncados a 128 dimensiones, ~250 MB — seis veces menos. El trade-off: se retiene ~90% de la calidad en texto, pero solo ~75% en imagen, video y audio. Google recomienda truncar solo si el storage o la velocidad lo exigen.
Los detalles que muerden (según Reddit)
La comunidad ya sacó dos lecciones prácticas de la primera versión que siguen aplicando:
- Los prefijos de tarea no son opcionales: indexar documentos con el prefijo de query en vez del correcto degrada el recall de forma notable.
- Con MRL, primero cortás y después normalizás: normalizar a 768 y después recortar deja vectores fuera de norma y te arruina la búsqueda.
Detalles finos, pero del tipo que hace que tu RAG funcione o no.
Para equipos armando búsqueda semántica o pipelines RAG sin depender de una API propietaria, EmbeddingGemma 2 se posiciona como una opción seria: abierto, compacto, multimodal y con la calidad que suele traer la familia Gemma.
Fuentes: Google Developers Blog, InfoQ, Hugging Face.