Tienes un agente de IA en producción. Latencia perfecta, costo por token controlado, cero errores técnicos, traces de cada tool call. Y sin embargo, nadie puede responder la pregunta que importa: ¿es bueno este agente o no? Esa es la brecha que quiere cerrar Grafana Labs con una propuesta publicada esta semana: aplicar los viejos y confiables SLOs y error budgets del SRE al comportamiento de agentes de IA.
El problema: las métricas tradicionales no ven la calidad
Una respuesta puede llegar en 800 ms, costar casi nada y tirar cero errores… y estar confiadamente equivocada. Latencia, tokens y error rates no miden si la respuesta fue correcta, si se basó en el contexto entregado o si le sirvió al usuario. Cada cambio al agente (tweak de prompt, cambio de modelo) pasa a ser una apuesta a ciegas.
Evaluaciones como SLI
La propuesta de Grafana: medir el comportamiento directamente con evaluaciones. Un juez — normalmente otro LLM, aunque un regex humilde también sirve para cosas deterministas — revisa una conversación y da un veredicto: ¿estuvo anclada en el contexto o se inventó cosas? ¿Hizo lo que el usuario pidió? ¿Fue tóxica? ¿Filtró información personal? ¿Cayó en un prompt injection?
El punto clave: la calidad no es un solo número. Un agente puede estar perfectamente anclado y ser carísimo, o ser útil y ocasionalmente tóxico. Grafana argumenta que hay que tratarlas como mediciones separadas con objetivos distintos, en vez de esconder fallas dentro de un “agent quality score” agregado.
Presupuesto de alucinaciones
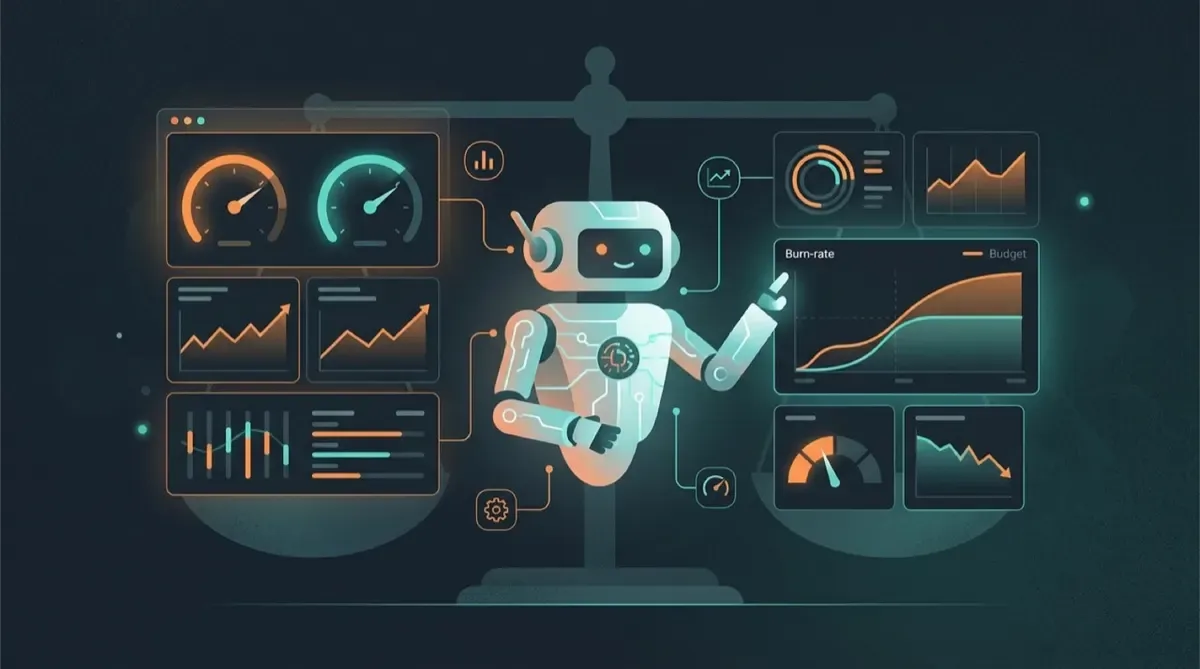
Una vez medible el comportamiento, todo el arsenal SRE se aplica directo. Ejemplo de Grafana: un SLO que exija que el 95% de las conversaciones sea evaluada como cumplida en 30 días. El 5% restante es tu error budget: la cantidad de comportamiento inaceptable que el equipo decidió explícitamente tolerar.
¿Para qué sirve? Para las mismas decisiones de siempre: si hay presupuesto disponible, experimentas con prompts y modelos; si se está quemando, priorizas calidad sobre cambios. Y especialmente para detectar drift gradual: un agente puede seguir respondiendo “exitosamente” mientras sus respuestas se vuelven sutilmente menos útiles, día a día, sin disparar ni una alerta convencional. El burn rate del error budget hace visible esa degradación lenta.
De where salió la idea
No es teoría de laboratorio: nació del trabajo de Grafana monitoreando su propio Grafana Assistant (disponible como Agent Observability en Grafana Cloud), donde cambios de prompt, modelo y herramientas dejaron insuficiente el monitoreo tradicional. La parte difícil, reconocen, no es crear el SLO sino decidir qué es “aceptable”: no hay décadas de consenso tipo “cuatro nueves” para cumplimiento de tareas. Su recomendación: partir con un baseline de evaluaciones históricas y apretar el objetivo a medida que el agente madura.
Los SREs llevan años viviendo de error budgets para balancear velocidad y confiabilidad. La gracia es lo natural que se mapea a agentes: la confiabilidad ya no es “¿respondió el servidor?”, sino “¿respondió bien?”. Y eso también se puede presupuestar.