El dashboard de costos no mentía: un cluster de nodos con 8 GPUs cada uno, todas mostrando “Allocated: 1/1”. Finance preguntando por qué la boleta parecía un data center chico. Y al correr nvidia-smi por todo el fleet: utilización al 10%. Un modelo 7B en BF16 ocupando un dieciseisavo de 80 GB de VRAM.
Cada pod había agarrado una GPU completa. No porque la necesitara, sino porque era lo único que sabía pedir.
El problema de vocabulario
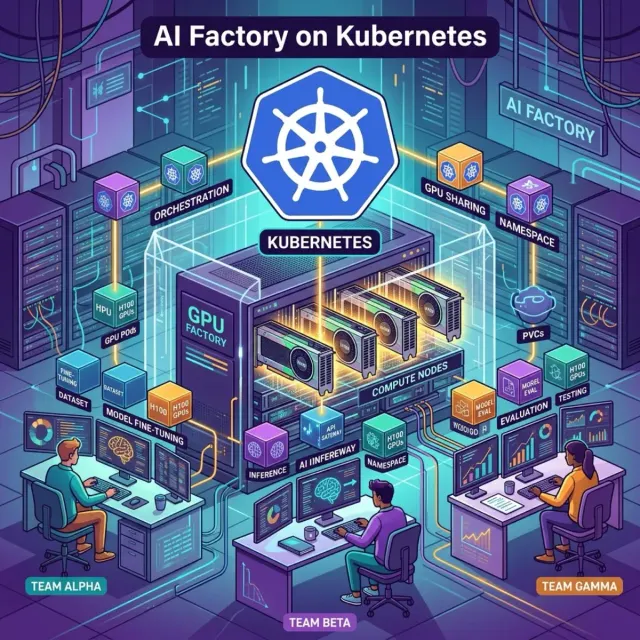
Kubernetes trata las GPUs como recursos enteros: nvidia.com/gpu: 1. El scheduler cuenta tarjetas y reparte en unidades de 1. No sabe de VRAM, no sabe de streaming multiprocessors, no sabe qué fracción del silicio estás usando realmente.
El problema es que un pod sirviendo un LLM no es stateless ni rápido de reemplazar. Los pesos del modelo pueden tardar decenas de segundos en cargarse en memoria. Matar y recrear el pod no es gratis.
Las tres herramientas de compartición
NVIDIA ofrece tres enfoques principales para partir GPUs:
1. Time-slicing — La opción más simple. Multiple pods comparten una GPU turnándose. Ideal para workloads de baja criticidad donde algo de latencia es aceptable.
2. MPS (Multi-Process Service) — Mayor throughput entre workloads que se confían entre sí. Comparte el contexto de ejecución sin aislamiento completo.
3. MIG (Multi-Instance GPU) — Particiones con aislamiento de hardware. Cada slice es una GPU lógica independiente. Es la opción más robusta para producción seria.
Tratando pods de LLM como lo que son
El artículo de Cloud Native Now hace un punto clave: los pods que sirven LLMs deberían tratarse como stateful, no como cattle desechable. Eso significa:
- Model caching a nivel nodo para reducir cold starts
- Delays de readiness apropiados para dar tiempo a cargar pesos
minReplicassensatos en vez de scale-to-zero agresivo- Autoscaling que entienda que levantar un pod nuevo no es instantáneo
DRA: el futuro del scheduling de GPUs
Dynamic Resource Allocation (DRA) es la dirección de largo plazo de Kubernetes para esto. En vez de contar GPUs como enteros, DRA le da al scheduler un modelo más rico: puede entender los atributos del dispositivo (VRAM, tipo de acelerador, capacidades) y asignar basándose en eso.
DRA ya está disponible pero todavía madurando. Mientras tanto, la combinación de MIG/MPS/time-slicing + buenas prácticas de scheduling es lo que tiene la gente en producción.
El take
Si estás corriendo inference de LLMs en Kubernetes y cada pod tiene una GPU dedicada, revisa nvidia-smi. Si la utilización está bajo 50%, estás regalando plata. Las herramientas para compartir existen — la pregunta es si tu equipo las ha adoptado.