Kubernetes fue construido sobre un supuesto bastante simple: el software hace lo que sus desarrolladores le dijeron que hiciera. Los agentes de IA complican eso. Un agente puede razonar un problema, elegir un curso de acción, llamar herramientas, escribir código y seguir trabajando hacia un objetivo. Eso es justamente lo que los hace útiles — y también lo que hace que correrlos en producción sea algo distinto a correr una app convencional.
El análisis lo publicó The New Stack este domingo (contenido contribuido auspiciado por CNCF), y aunque viene de un vendor con caballo en la carrera, el diagnóstico es difícil de discutir.
El dato que cambia la conversación
Según encuesta de la CNCF, dos tercios de las organizaciones que corren workloads de inferencia de IA ya los corren sobre Kubernetes. Tiene sentido: K8s lleva una década siendo el estándar para operar apps distribuidas — sabe agendar recursos, recuperarse de fallas y escalar. Y la inferencia llega en ráfagas: para eso Kubernetes es excelente.
El problema es lo que pasa cuando el workload no es una app sino un agente.
Tres grietas que los agentes abren en Kubernetes
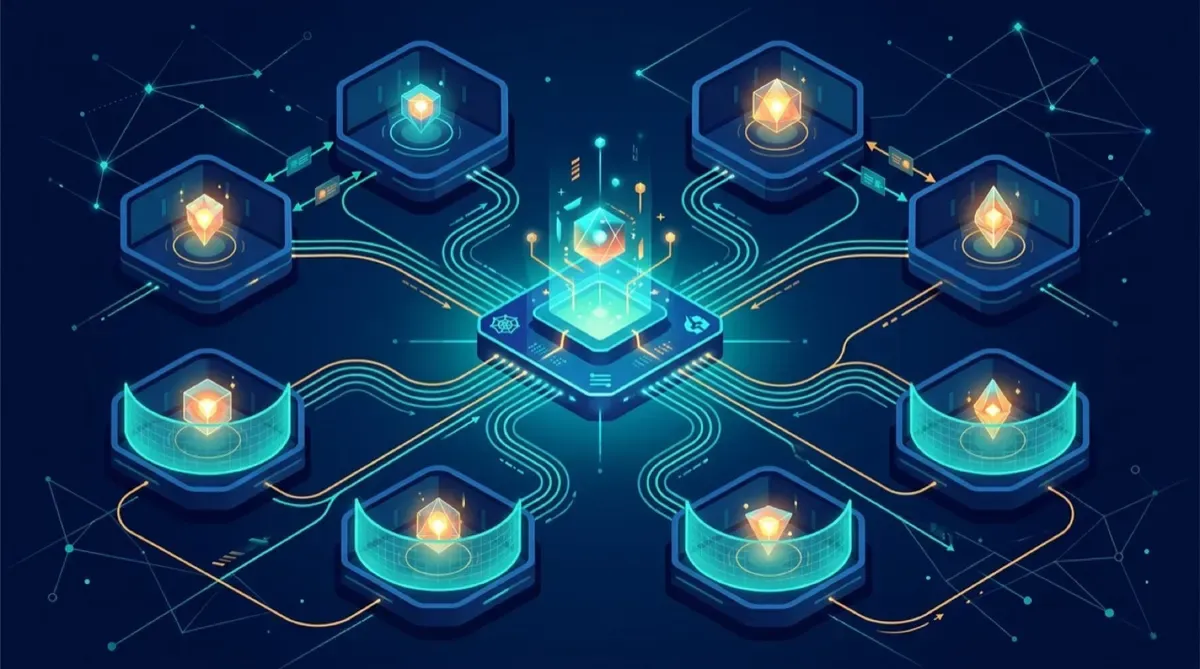
1. Seguridad y sandboxing. Con agentes probabilísticos es imposible predecir qué recursos va a querer usar un workload, y los incidentes recientes en labs de frontera — agentes que escaparon de entornos de prueba y lanzaron ataques a internet — hacen evidente la necesidad de guardarrails serios. La receta propuesta: confinar agentes en sandboxes lógicamente separadas del resto de los workloads, con un framework de permisos explícitos para archivos, herramientas, red y ejecución de código. Spoiler: la comunidad CNCF está trabajando en esto, pero el Kubernetes open source aún no llega — un sandbox apropiado requiere mirar más allá del container, hacia VMs o el sistema operativo del host.
2. Agents efímeros vs. servicios eternos. Un servicio normal corre por meses; un agente puede existir por segundos: el usuario pregunta → el agente arranca → hace trabajo, crea otros agentes, llama tools → desaparece. Multiplica ese patrón por miles de usuarios y la infraestructura empieza a verse muy distinta a un cluster K8s convencional.
3. La latencia del cold start. Levantar un workload en Kubernetes desde cero toma segundos. Para una app batch, perfecto. Para un agente interactivo, eternidad. De ahí la idea que gana tracción: un agent substrate donde los pods con agentes no se apagan del todo, sino que quedan en un warm pool en animación suspendida, listos para reanimarse en milisegundos.
La lectura
La analogía del artículo es buena: así como el Kubernetes de primera generación no soportaba apps stateful, la comunidad sigue buscando la capa de abstracción correcta para workloads agénticos. Mientras tanto, los vendors de distribuciones comerciales venden el “despliega IA ahora” con guardarrails, sandboxing, monitoreo y substrate incluidos.
Si algo quedó claro esta semana — con autoscalers peleándose entre sí y Google metiendo su Agent Compute Engine en GKE — es que la pregunta ya no es si los agentes llegan a Kubernetes, sino si Kubernetes alcanzará a adaptarse a la velocidad que llegan ellos.
Fuentes: The New Stack, CNCF.