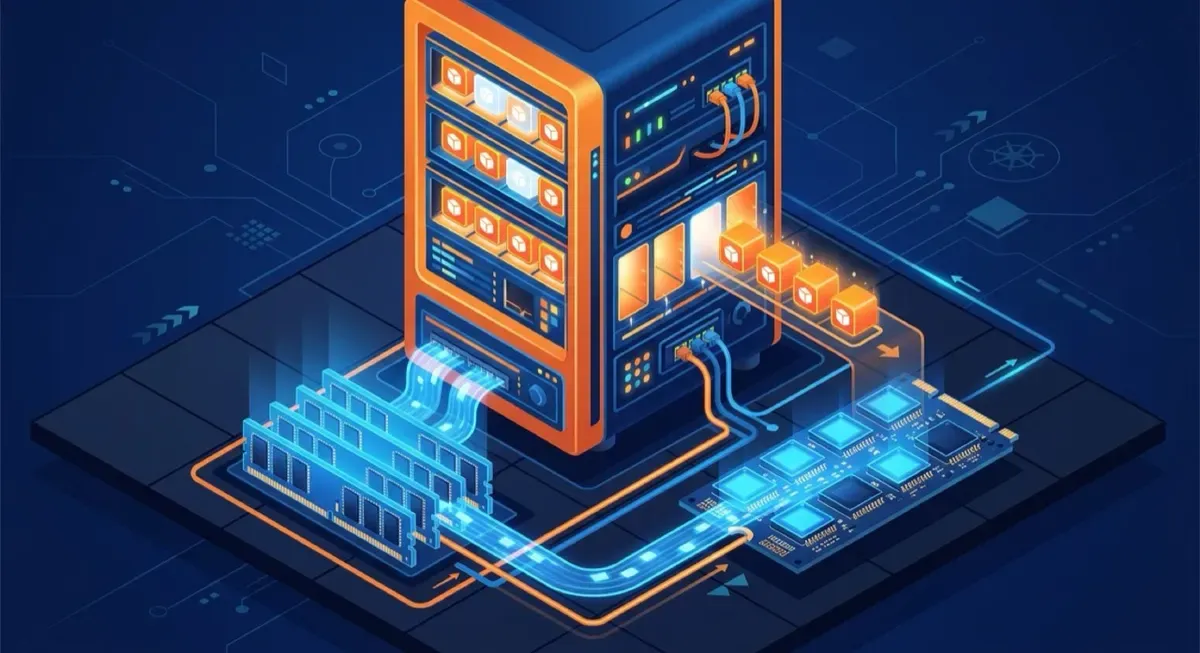
El blog oficial de Kubernetes publicó un post con benchmarks que viene a resucitar una palabra prohibida durante años en el ecosistema: swap. Con el soporte de swap en nodos ya en General Availability desde Kubernetes v1.34, y respaldando ese swap con SSDs NVMe locales, un nodo puede mandar a disco la memoria dormida de los pods y meter muchos más workloads en el mismo hardware. Spoiler: hasta 3x más densidad en el mejor caso.
El problema: RAM ociosa de los agentes
Los workloads agénticos de IA tienen un perfil de memoria Bien raro: exigen un footprint grande para arrancar y ejecutar código no confiable (piensa en agent-sandbox), pero después quedan gran parte del tiempo inactivos esperando el siguiente prompt. Esa memoria residente pero dormida es carísima, y limita cuántos pods caben en un nodo. El clásico dilema: límites de memoria altos = RAM cara ociosa; límites bajos = OOM kills.
Por qué el swap ahora sí funciona
Históricamente el swap estaba mal visto en Kubernetes por dos razones concretas:
- Accounting: con cgroup v1, memoria y swap compartían un solo límite combinado, haciendo el uso real impredecible. Con cgroup v2 el swap se contabiliza separado, y el soporte de Kubernetes se apoya en eso.
- Latencia: paginar a discos mecánicos era un castigo. Los Local SSD NVMe de hoy eliminan prácticamente esa penalización.
Los números
Los benchmarks cubren tres perfiles de workload, y la tabla es contundente:
| Workload | Sin swap | Con swap NVMe | Mejora |
|---|---|---|---|
| Build de kernel Linux (CI/CD) | límite 600 MB RAM | límite 300 MB RAM | -50% de RAM, sin slowdown |
| Headless Chrome (gVisor) | 80 pods | 160 pods | +100% densidad |
| Headless Chrome (Kata) | 40 pods | 50 pods | +25% densidad |
| Sandbox Python (gVisor) | 80 sesiones | 240 sesiones | +200% densidad |
Detalles finos que valen la pena:
- En el build del kernel Linux 6.1.1, con swap a Local SSD el contenedor corrió limpio en 374s vs 433s del baseline. Pero ojo: comprimir el límite a 200 MB forzó el working set activo a swap y el tiempo subió +40%. Moraleja: el swap es seguro para memoria burst, no reemplaza la RAM activa.
- En los picos de densidad, el aumento de latencia por pod viene sobre todo de la competencia por CPU, no del I/O de swap.
- El caso estrella: sesiones Python aisladas analizando datos de MovieLens 20M (~375 MiB residentes cada una) pasaron de 80 a 240 sesiones concurrentes por nodo.
Cómo activarlo
Si manejas Kubernetes para entornos de desarrollo, farms de testing de navegadores, apps JVM o runtimes de ejecución de IA, la configuración upstream en v1.34+ es directa:
kind: KubeletConfiguration
apiVersion: kubelet.config.k8s.io/v1beta1
failSwapOn: false
memorySwap:
  swapBehavior: LimitedSwap
Y hay que configurar los workloads con QoS Burstable (memory limits mayores que los requests) para que el nodo racione el swap según el uso dormido. En GKE esto ya está disponible de forma nativa vía Node Memory Swap sobre perfiles de Local SSD.
El takeaway es claro: en la era agéntica, donde los pods viven largos ratos al puro esperar, el swap con NVMe deja de ser tabú y se convierte en palanca directa de costo por pod. El detalle completo, con código de despliegue, está en los directorios de ejemplos de agent-sandbox en GitHub.