Netflix publicó en su tech blog cómo está construyendo su plataforma de confiabilidad para jobs grandes de entrenamiento e inferencia sobre Kubernetes. La síntesis de InfoQ lo pone en una frase: a miles de GPUs, la confiabilidad ya no es “mantener máquinas disponibles”, es un problema de sistemas distribuidos.
El problema
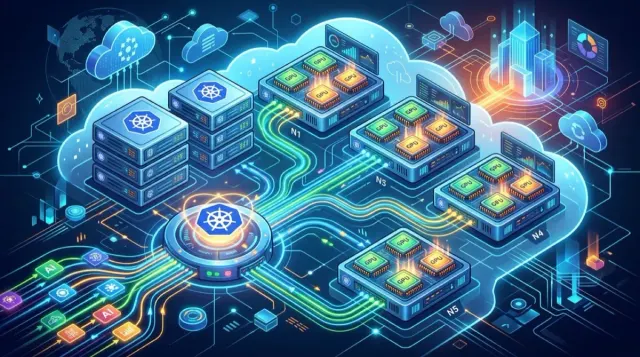
Un training grande corre semanas en cientos de GPUs operando en lockstep. Una sola GPU muerta, un adaptador de red degradado o una máquina lenta puede detener —o frenar gravemente— todo el workload. No hay margen para “revisar mañana”.
Los resultados que reporta Netflix con este enfoque: más de 99,95% de disponibilidad en nodos GPU y el éxito de jobs saltando de ~98% a más de 99,5%.
Health checks por capas que fallan “cerrado”
Un health check convencional confirma que la VM está viva y alcanzable, no que su GPU sirva para training distribuido. Netflix encontró que una GPU puede responder normal a un status query y fallar apenas se asigna memoria o arranca cómputo sostenido. Y un NIC puede estar “presente” con menos enlaces de lo esperado, dejando las operaciones colectivas corriendo a bandwidth miserable.
Su respuesta: chequeos por dispositivo con NVIDIA DCGM (errores de GPU, memoria, interconect, condiciones térmicas) más chequeos de red que inspeccionan estado y cantidad de interfaces EFA. Un agente de nodo Kubernetes convierte todo eso en node conditions sobre los que los controllers pueden actuar.
Detalle que enamora: los checks están diseñados para fallar cerrado. Si la herramienta de diagnóstico se cuelga, su timeout marca la máquina como unhealthy — un check roto nunca reporta éxito. Y si el mecanismo de diagnóstico GPU falla, hay rutas de respaldo con kernel logs.
Remediación progresiva, no reposición inmediata
Detectar la falla es la mitad. Los controllers de Netflix responden en escalera en vez de reemplazar la máquina completa de entrada:
- Un problema transitorio bloquea trabajo nuevo sin tocar los workloads corriendo.
- Si persiste, la máquina se drainea y sus workloads se mudan.
- Según la falla: matar el job problemático, reset de GPU, reboot de máquina o reemplazo total.
Todo integrado con las capacidades de auto-repair de Karpenter, con políticas que definen cuánto tolerar cada tipo de falla y cuánto puede disruptuarse el cluster a la vez.
Haciendo las fallas baratas
Netflix asume que las fallas de hardware no se eliminan; las hace más baratas de recuperar:
- Checkpointing + elastic workers: el training retoma desde el último checkpoint sano al perder una máquina.
- Reintentos automáticos, con las fallas de aplicación clasificadas aparte para no reiniciar en loop un job con bug de software real.
- Detección del slow rank: una GPU no necesita morir para arrastrar un workload síncrono — identificar al rezagado es parte del trabajo.
En inferencia usan MIG para que workloads chicos compartan GPU con aislamiento de memoria entre tenants, y van camino al Dynamic Resource Allocation (DRA) de Kubernetes para placement topology-aware (GPU, NIC y CPU bien ubicados dentro de cada máquina).
Por qué importa
Meta reportó que el 66% de las interrupciones de training de Llama 3 fueron fallas de hardware. La lección es la misma para ambos: a escala de miles de GPUs, validar hardware antes de agendar, monitorear en ejecución, identificar el failure domain, remediar automático y medir goodput es el loop operativo completo.
Y lo mejor: el patrón es replicable con piezas abiertas (DCGM exporter, Karpenter, node conditions) por cualquier equipo que corra ML serio sobre Kubernetes. No necesitas el presupuesto de Netflix para copiar la arquitectura.