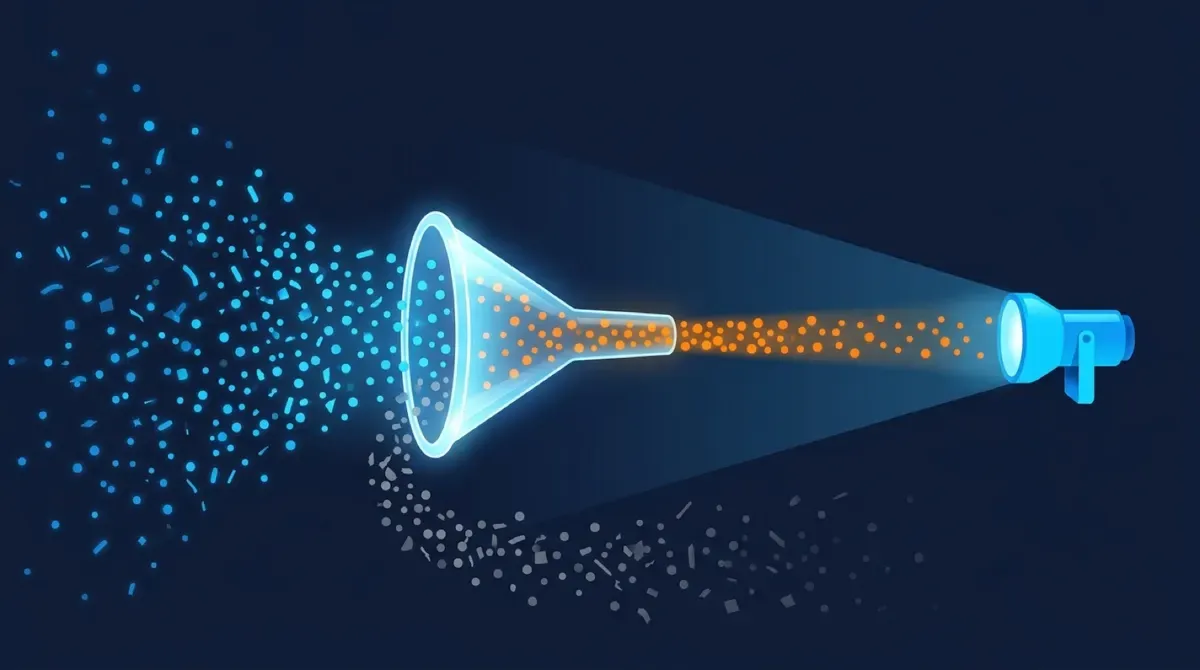
AWS le metió un upgrade serio a Amazon S3 Vectors: ahora soporta metadata pre-filtering, o sea, el filtro de metadatos se evalúa ANTES de la búsqueda de similitud. Resultado: hasta 5x más recall en búsquedas con filtros selectivos, sin costo adicional, sin re-ingestar datos y sin cambiar tus queries.
El problema que resuelve
Casi ninguna aplicación busca un índice completo: busca la parte de un tenant, usuario o categoría específica. Antes, en modo CLASSIC, la búsqueda vectorial y el filtro se evaluaban en tándem, y los candidatos salían del índice completo — con la consecuencia de que query filtradas “dejaban caer” resultados relevantes.
Ahora con índices en modo ENHANCED, S3 Vectors resuelve primero el filtro y busca solo entre los vectores que coinciden. El ejemplo de AWS lo deja claro: soporte con 8 millones de tickets donde un cliente tiene 400; antes los candidatos salían de los 8 millones, ahora de los 400. La diferencia en recall se nota de inmediato.
Lo que trae la funcionalidad
$startsWithpara matching por prefijo en paths, URLs y claves jerárquicas.- Hasta 2 KB de metadatos filtrables por vector.
- Hasta 100 restricciones de filtro por query.
- Los índices existentes quedan en CLASSIC hasta que los actualices; ojo con los nuevos permisos IAM.
Casos de uso obvios: e-discovery legal (scope por cliente y carpeta), research financiera (por emisor, tipo de documento y fecha), media (rating y licencias regionales) y — el más interesante — apps agénticas, donde el agente filtra por owner, set de documentos y timestamp para que su búsqueda cubra justo lo relevante para la tarea.
El punto: para RAG y plataformas multi-tenant, el recall en búsquedas filtradas era un dolor conocido y bastante silencioso. Que se arregle con un flag de index mode y a costo cero es de esas noticias chicas en titular y grandes en práctica.
Fuentes: AWS News Blog