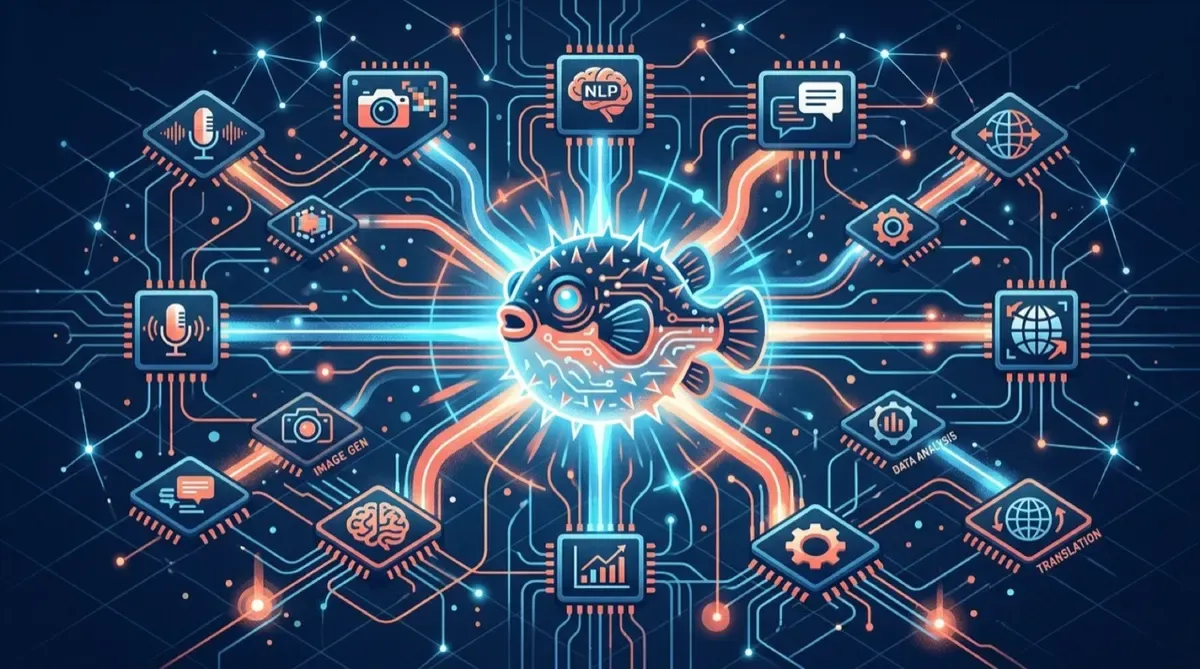
Sakana AI viene empujando una tesis rara para estos tiempos: que el futuro no es un modelo gigante que lo resuelve todo, sino una capa de orquestación que elige qué modelo usar para cada tarea, al menor costo posible. Hoy le da otra vuelta de tuerca con dos lanzamientos simultáneos: Fugu Max y Fugu Ultra v2.
Fugu Max: más modelos, menos plata
La gracia de Fugu Max es que expande el pool de modelos que puede orquestar, sumando una cantidad sin precedentes de modelos open-weights y especializados, incluida la familia NVIDIA Nemotron (fruto de la colaboración que arrancaron en agosto). La idea es simple: enrutar cada tarea al modelo más liviano capaz de resolverla, en vez de tirarle un monstruo multi-trillón de parámetros a un lookup de datos.
Los números que suelta Sakana:
- Precio: US$2 por millón de tokens de input y US$6 por millón de output. Eso es 40-60% más barato que Sonnet 5, GPT 5.6 Terra y Kimi K3 en el output.
- Rendimiento: mejor score global en seis benchmarks (Terminal Bench 2.1, GPQAD, AA-LCR, GDP.pdf, AutomationBench y SWEFish, su benchmark interno).
- Eficiencia: expande la frontera de Pareto costo-rendimiento en siete de diez benchmarks.
El argumento de fondo es que los modelos abiertos son la parte del ecosistema que más rápido crece, y que orquestados rinden mucho más que aislados. Fugu Max es la apuesta de que la frontera del futuro se va a construir con muchos modelos abiertos y especializados trabajando en conjunto, no con un solo titán.
Fugu Ultra v2: el techo sigue subiendo
Si Fugu Max va por el costo, Fugu Ultra v2 va por el rendimiento puro en tareas complejas: razonamiento multi-paso, investigación autónoma y desarrollo full-stack. El detalle jugoso acá es que ya no depende de los modelos frontier que orquesta: el upgrade logra un score más alto con un pool más chico, sin Claude Fable 5 ni GPT-6 Astra en la mezcla.
Por qué importa
Sakana está plantando la bandera de que la orquestación le gana consistentemente a los modelos aislados, y que un pool de agentes intercambiables te da resiliencia de supply chain por diseño: si un modelo se cae o sube de precio, cambias la pieza sin rehacer el sistema.
Para el que opera infraestructura de IA, es un recordatorio de que la conversación ya no es solo “qué modelo compro”, sino “qué capa de ruteo me deja mezclar modelos sin quedar pegado a uno”. El lock-in se está moviendo de capa.
Fuentes: Sakana AI, MarkTechPost, orcarouter.