La destilación de modelos (Model Distillation) ha sido un tema candente últimamente. Básicamente, consiste en usar las respuestas de un modelo “frontera” gigante y caro (como GPT-5.6 o Claude Opus) para entrenar o afinar modelos más pequeños, baratos y rápidos, ahorrándose millones en I+D.
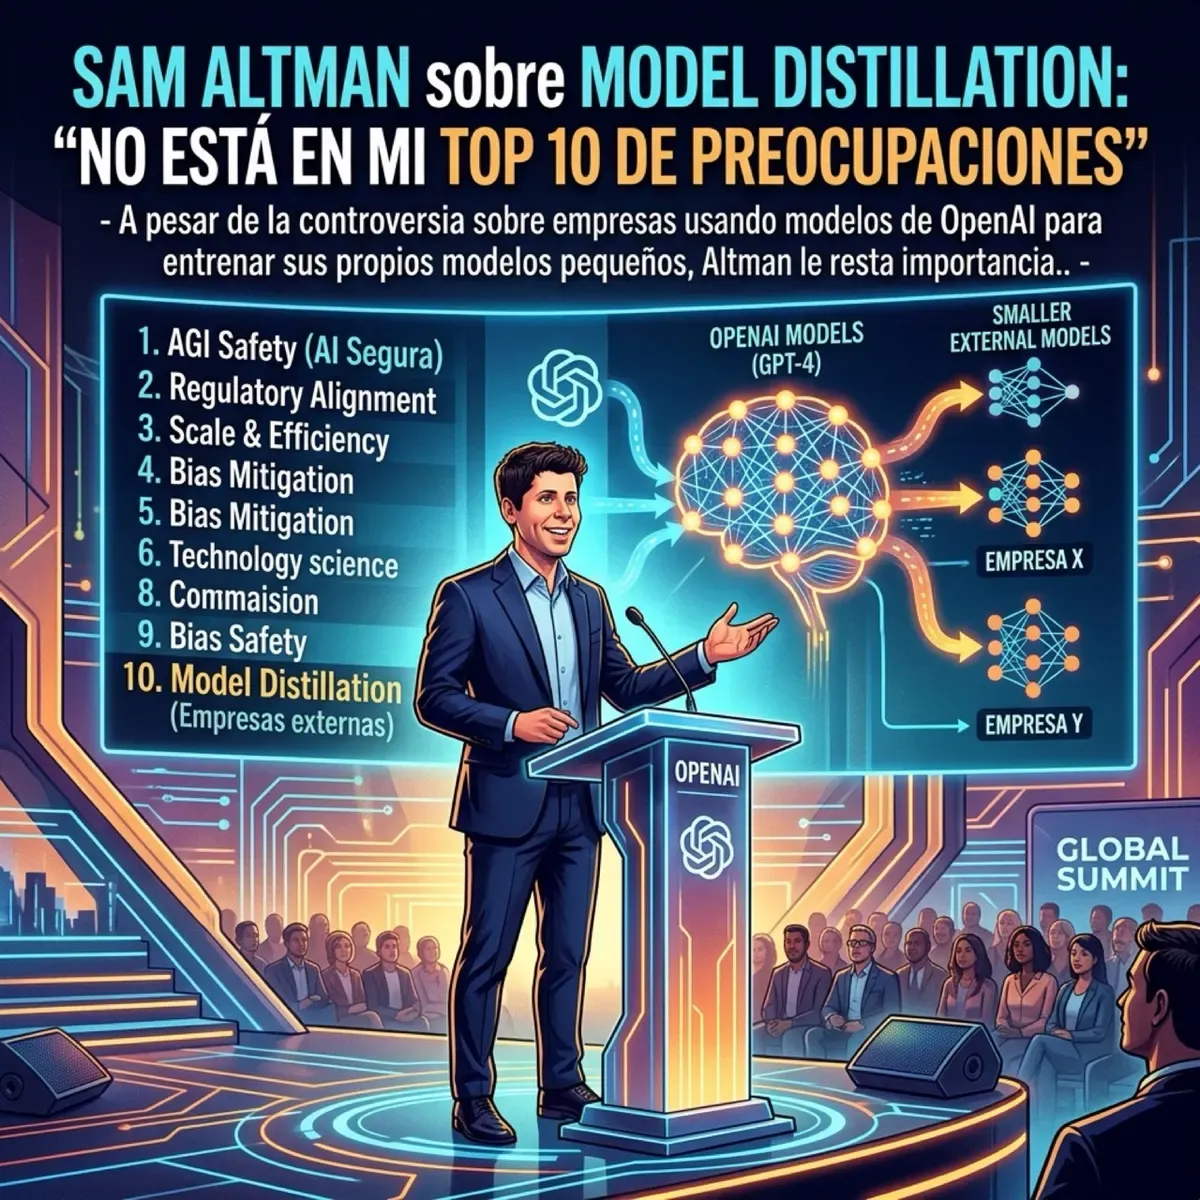
Muchas empresas de IA tienen términos de servicio estrictos que prohíben explícitamente usar el output de sus modelos para entrenar a la competencia. Sin embargo, en una reciente declaración, Sam Altman (CEO de OpenAI) le bajó el perfil a esta práctica.
“Preferiría que la gente no nos destilara, seguro. Pero esto no está en mi top diez de lista de preocupaciones”, comentó Altman.
Esta declaración es interesante porque muestra la confianza de OpenAI en su escala bruta. Para ellos, el verdadero negocio está en el ecosistema, la computación masiva y en el uso directo a gran escala (agentes y enterprise), en lugar de andar persiguiendo a startups que raspan sus datos para crear modelos locales.
Mientras algunos ven la destilación como “robo de propiedad intelectual”, Altman parece estar jugando un ajedrez a un nivel donde esos problemas son apenas ruido de fondo.