Microsoft aprovechó KubeCon North America 2026 para su actualización open source del 10 de noviembre, y la estrella fue networking: cross-cluster networking para AKS llegó a general availability a través de Azure Kubernetes Fleet Manager, como parte de Advanced Container Networking Services (ACNS). En paralelo, multi-NIC pods se mantiene en public preview y DRANET se extiende a RDMA y GPU pools.
Qué significa el GA
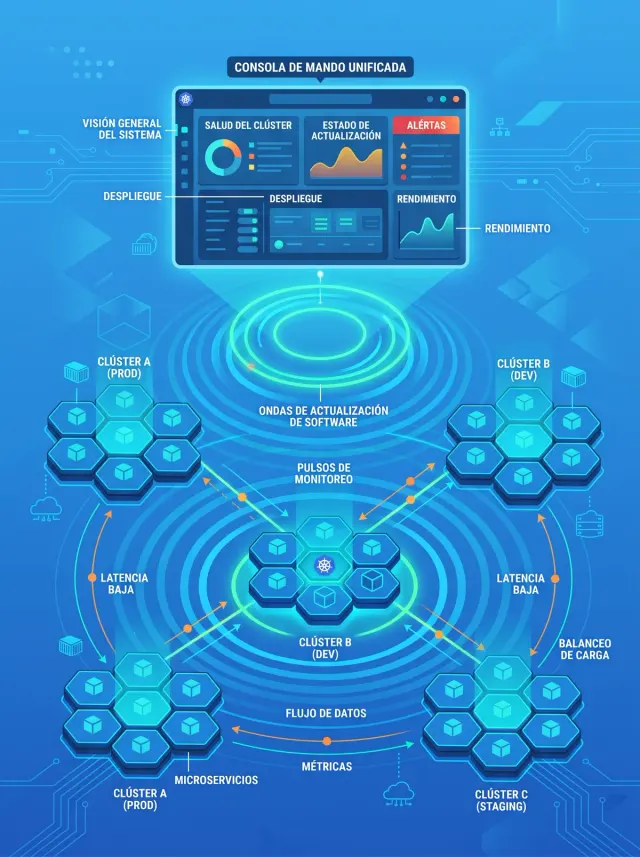
La promesa es simple de enunciar y compleja de ejecutar: pods en clusters distintos comunicándose directamente, sin gymnastics de service mesh casero ni peering manual de VNETs. La implementación es un mesh Cilium administrado por Microsoft — o sea, el que hoy es el estándar de facto para networking eBPF en Kubernetes, pero con la parte operativa (upgrades, configuración, soporte) fuera de tu lista de pendientes.
El contexto importa: AKS viene mutando de “un cluster administrado” a plataforma multi-cluster, con Fleet Manager como capa de orquestación. El networking cross-cluster era la pieza que faltaba para que esa historia sea usable de verdad — clusters por región, por equipo o por dominio de carga, comportándose como una sola red.
La letra chica (que siempre está)
Como suele pasar en estos anuncios, hay matices que los titulares omiten:
- Algunas páginas de la documentación de Microsoft todavía etiquetan cross-cluster networking como Preview, pese al anuncio de GA. Si vas a producción con esto, confirma el estado en la doc oficial antes de rediseñar topologías.
- Multi-NIC pods sigue siendo preview y la documentación indica que no está pensado para producción todavía.
- Hay límites de routing y prerrequisitos (modelo de red overlay vs. pod subnet) que conviene mapear antes de mover un solo workload.
El ángulo IA/HPC que casi nadie mira
La parte de multi-NIC y DRANET no es un capricho de networking nerds. Los equipos que corren entrenamiento e inferencia en Azure quieren interfaces de red secundarias para tráfico RDMA hacia GPU pools — separar el plano de datos de IA del tráfico ordinario del cluster. Es la misma lógica de siempre: a las GPU hay que alimentarlas bien o se pasan la mitad del tiempo esperando datos.
Qué hacer si operas AKS
- Prueba cross-cluster networking en un entorno no productivo con dos clusters del mismo tenant y mide latencia y límites reales antes de creerle al diagrama.
- Si estás en el mundo fleet/multi-cluster, este GA reduce bastante el costo de las topologías activo-activo entre regiones.
- Guarda los DRANET + GPU pools para cuando estén fuera de preview, salvo que te guste vivir al límite con letra chica.
Lectura rápida: Microsoft está jugando en serio la carta multi-cluster en AKS, y el mesh Cilium administrado elimina la excusa técnica más común. Ahora la pregunta es de arquitectura, no de factibilidad.