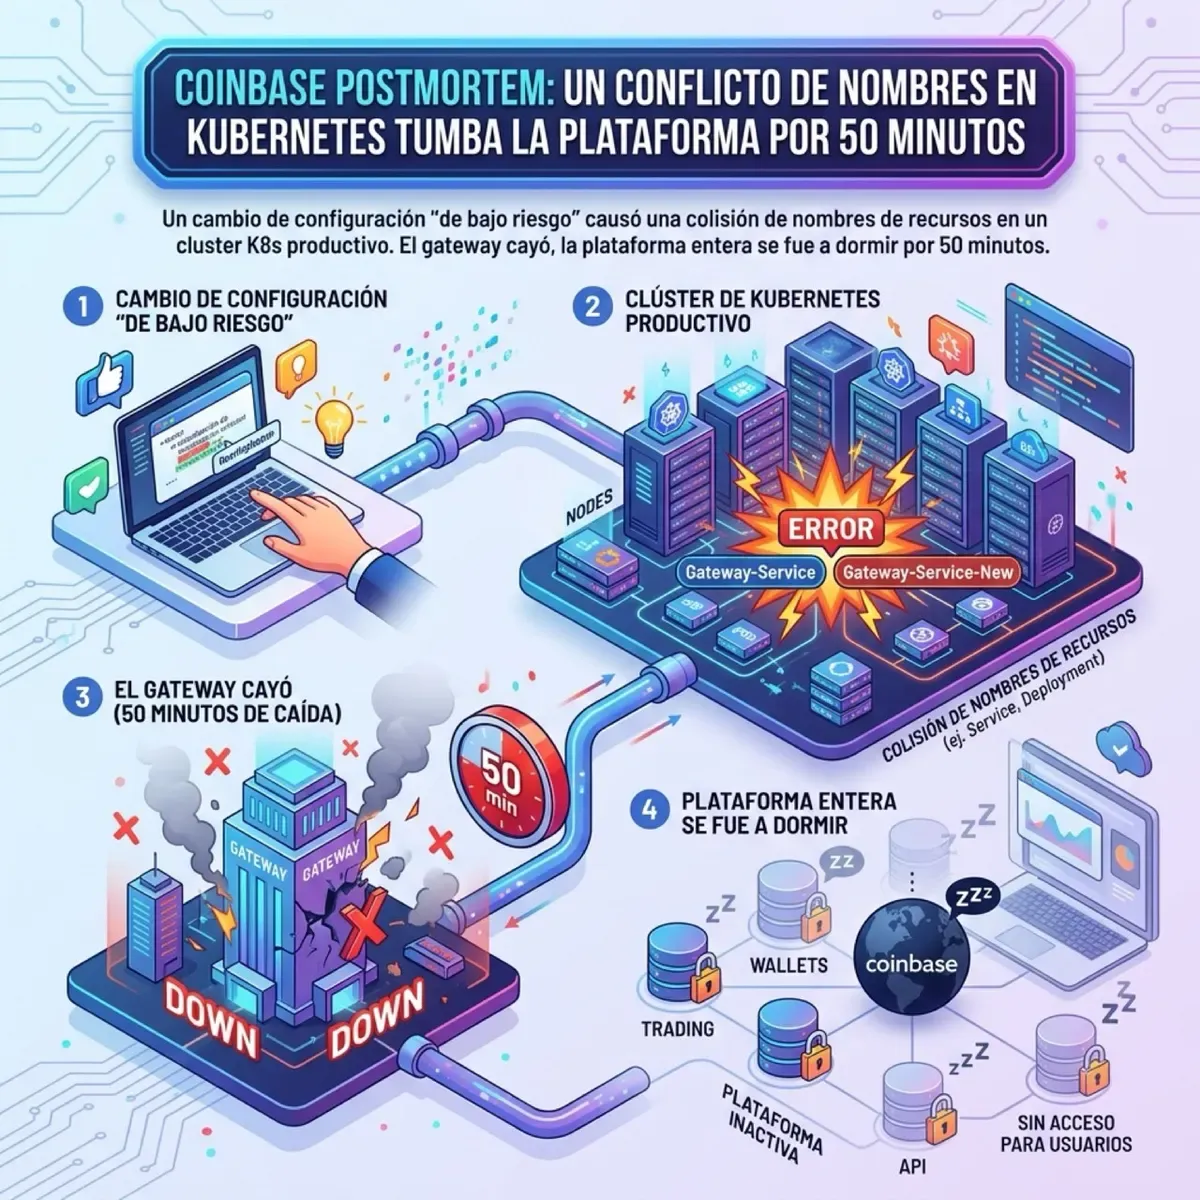
La frase “era un cambio de bajo riesgo” debería ya tener su propio cementerio. Coinbase publicó ayer el postmortem de su outage del 14 de julio, y la causa raíz es tan clásica como dolorosa: dos recursos de Kubernetes terminaron con el mismo nombre.
Qué pasó
El 14 de julio a las 12:34 PM ET, un cambio rutinario de configuración se desplegó en un cluster Kubernetes compartido de producción que hospeda servicios de infraestructura core. El cambio contenía una colisión en los nombres de recursos — dos cosas reclamando el mismo identificador — y eso modificó un gateway crítico dejándolo completamente indisponible.
Resultado: 50 minutos de outage total. Retail, institucional, onchain y developer platforms, todos caídos. Transacciones “in-flight” quedaron congeladas hasta que el servicio se restauró. Fondos de usuarios nunca estuvieron en riesgo.
Por qué es interesante
Esto no fue un hack, ni un bug exótico, ni un caso edge-case increíblemente raro. Fue un naming conflict — el tipo de cosa que le pasa a cualquier equipo que opera Kubernetes a escala. Algunos puntos destacables:
- “Low-risk” no significa “no-risk”. El cambio estaba clasificado como de bajo riesgo, lo que significa que probablemente saltó revisiones más estrictas o canary deployments
- Cluster compartido = blast radius grande. Un solo cluster K8s para infra core significa que un conflicto de nombres no afecta un servicio, afecta todo
- Dependencia circular de deployment. El postmortem también reveló que existía una dependencia circular en el proceso de deployment, lo que hizo la recuperación más lenta
- Tercer incidente operativo de Coinbase en 2026. No es la primera vez este año
Lecciones para el equipo
Esto es un caso de estudio de por qué la gobernanza de configuración en Kubernetes importa:
- Validación de nombres antes de aplicar. Tools como Kyverno, OPA Gatekeeper o incluso pre-commit hooks pueden detectar colisiones antes de que lleguen al cluster
- Cluster segregation por criticidad. Si tu gateway crítico vive en el mismo cluster que “cambios de bajo riesgo”, el blast radius es global
- Canary obligatory para shared infra. No importa cuán “low-risk” sea el cambio, si toca infra compartida, tiene que pasar por un canary
- Eliminar dependencias circulares de deployment. Si necesitas el gateway arriba para deployear el fix del gateway, tienes un problema de diseño
El detalle humano
Lo más revelador del postmortem es la honestidad: un cambio clasificado como rutinario, en un cluster compartido, sin suficientes salvaguardas. Es exactamente el tipo de cosa que le pasa al mejor equipo cuando la confianza en el proceso se normaliza.
“A naming collision in a routine configuration change knocked the exchange offline.”
Coinbase cumplió en publicar el postmortem completo y transparente. Eso se valora. Pero el patrón se repite: la complejidad operativa de Kubernetes no perdona, y “rutinario” es la palabra más peligrosa en el vocabulario de SRE.
Fuentes: The Block, Crypto Briefing, Seeking Alpha