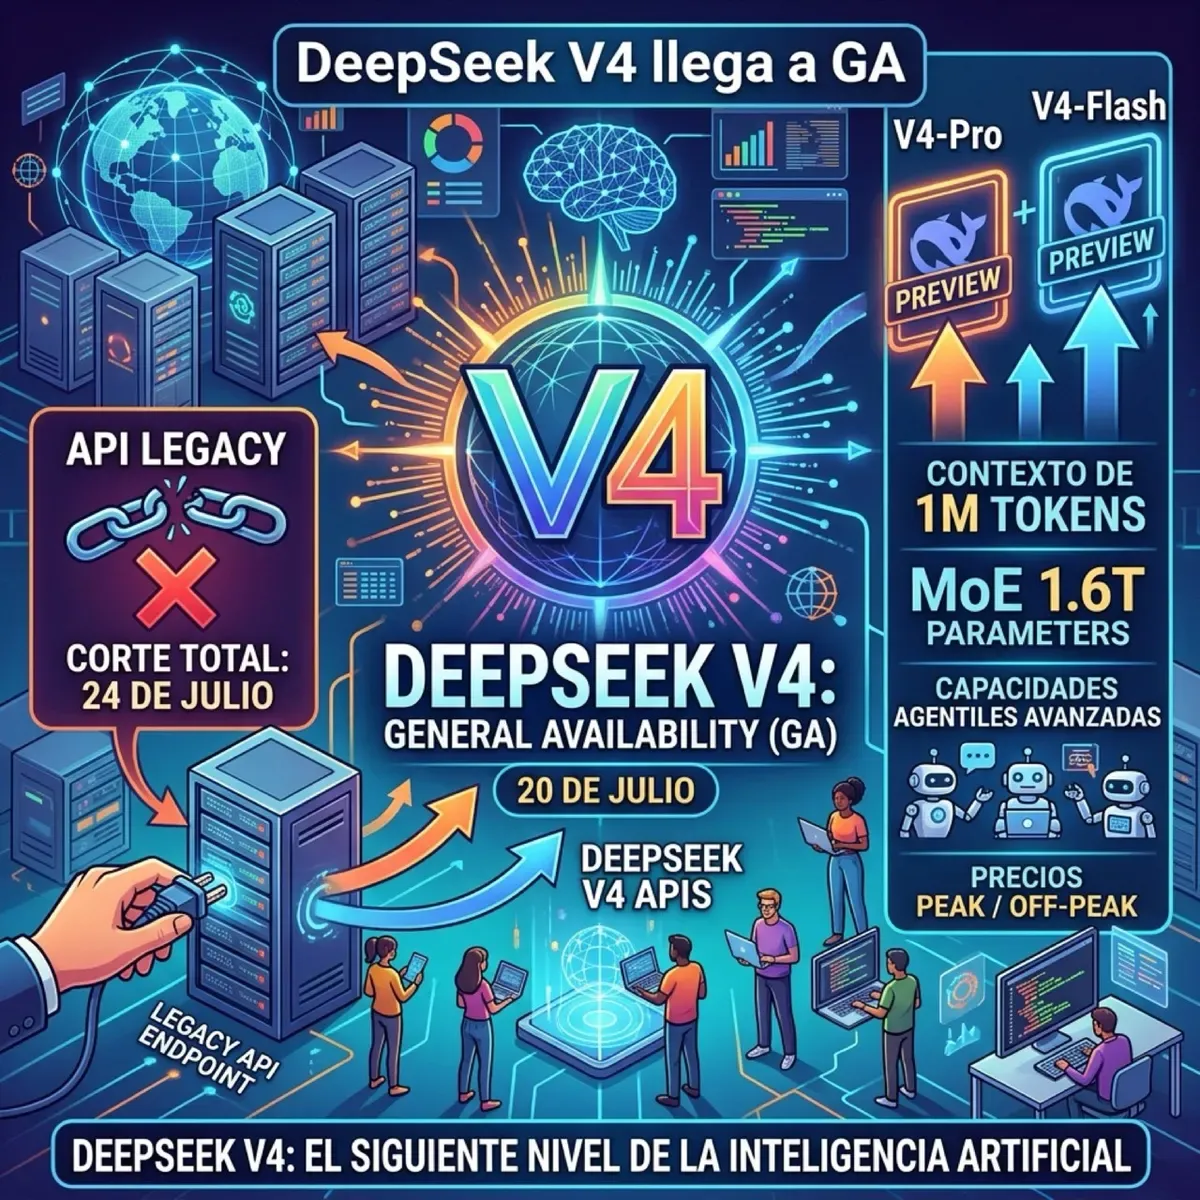
DeepSeek pasó de preview a general availability el 20 de julio, y cuatro días después cortó de raíz la API legacy. Si tenías deepseek-chat o deepseek-reasoner hardcoded en algún lado, ya estás recibiendo errores.
Lo que trae V4
Dos modelos componen la familia:
DeepSeek V4-Pro
- Arquitectura: Mixture of Experts con 1.6 trillones de parámetros totales, 49B activados por token
- Contexto: 1 millón de tokens por defecto
- Enfoque: Razonamiento complejo, tareas agentiles, tool use, ingeniería de software
- Pricing: US$0.435/M input — US$0.87/M output
DeepSeek V4-Flash
- Más liviano, optimizado para alto volumen
- Pricing: US$0.14/M input — US$0.28/M output (off-peak)
El build de GA añadió capacidades agentiles, mejor razonamiento matemático y mejoras dedicadas en generación de código sobre los modelos preview que venían corriendo desde abril.
Pricing peak/off-peak: novedad para DeepSeek
Por primera vez, DeepSeek introdujo billing diferenciado por horario. El pricing sube en horas peak y baja en valle. Si estás orchestando workloads asíncronos, mover jobs al off-peak puede reducir costos de inferencia en más de un 50%.
comparado con la competencia: V4-Flash a $0.14/M input es absurdamente barato. Para contexto, Claude Opus 4.8 cobra 23× más. Es la razón por la que DeepSeek ya procesa más de un tercio de los tokens en OpenRouter.
El corte de la API legacy
El 24 de julio a las 15:59 UTC, los aliases deepseek-chat y deepseek-reasoner dejaron de funcionar completamente. Cualquier integración que siga apuntando a esos nombres recibe failed requests en vez de respuestas.
La migración en la mayoría de los casos es un simple swap de nombre de modelo en la llamada API:
deepseek-chat→deepseek-v4-flash(odeepseek-v4-pro)deepseek-reasoner→deepseek-v4-pro
Por qué importa
DeepSeek está demostrando que el modelo de open-weight + API barata + calidad frontier es sostenible. La estrategia es clara: comerse el mercado de volumen con V4-Flash (donde la gente ya no quiere pagar premium de OpenAI/Anthropic) y competir en capacidades con V4-Pro para agentes y coding.
El dato clave: según datos de Vercel y OpenRouter, DeepSeek ya procesa más de un tercio de todos los tokens mientras Anthropic captura más del 50% del gasto. La guerra no es de revenue, es de volumen. Y el volumen se está moviendo rápido.
Con V4 en GA, pricing peak/off-peak, y la API legacy ya cortada, DeepSeek está enviando una señal clara: ya no son un experimento, son infraestructura de producción. Si tu estrategia multi-modelo no los tiene en el stack, probablemente estás pagando de más.
Fuentes: DeepSeek oficial, tech-insider.org, OpenRouter, BenchLM
Update: 01 de Agosto de 2026 - DeepSeek lanza silenciosamente la versión V4-Flash-0731
Solo unos días después de pasar a GA, DeepSeek actualizó en silencio el endpoint de su API con el modelo DeepSeek-V4-Flash-0731. Aunque la arquitectura se mantiene (284B de parámetros totales, ~13B activos), el modelo recibió un “re-post-training” agresivo específicamente para mejorar su desempeño en tareas agentiles. Según la comunidad en Reddit y Hugging Face (donde también liberaron los pesos abiertos), este upgrade es una respuesta directa al volumen masivo que están manejando. La actualización aplica automáticamente al usar el endpoint deepseek-v4-flash, consolidando su estrategia de dominar el mercado de agentes de bajo costo.
Update: 01 de Agosto de 2026 - Los benchmarks de V4-Flash-0731 son una bestialidad
Los números completos del V4-Flash-0731 se publicaron el 31 de julio y son alarmantes. Sin cambiar absolutamente nada de la arquitectura — mismo MoE 284B, mismos ~13B parámetros activos por token, mismo contexto de 1M — DeepSeek solo hizo re-post-training y los resultados en benchmarks agentiles se dispararon:
| Benchmark | V4-Flash-0731 | V4-Flash (Preview) | V4-Pro (Preview) |
|---|---|---|---|
| Terminal Bench 2.1 | 82.7 | 61.8 | 72.1 |
| DeepSWE | 54.4 | 7.3 | 12.8 |
| Cybergym | 76.7 | 38.7 | 52.7 |
| Toolathlon-Verified | 70.3 | 49.7 | 55.9 |
| NL2Repo | 54.2 | 39.4 | 38.5 |
DeepSWE saltó de 7.3 a 54.4 — un 7.5x de mejora solo con post-training. Y ojo: le gana al V4-Pro Preview (1.6T parámetros) en los 9 benchmarks agentiles publicados, teniendo apenas un cuarto de los parámetros activos por token.
En Artificial Analysis, el modelo alcanzó un Intelligence Index de 50, bastante arriba del promedio para modelos open-weight de su tamaño. Eso sí, destacan que es inusualmente verboso: generó 210M tokens en el suite de evaluación vs un promedio de 100M. Y cuando pagas por output token, esa verbosidad tiene costo real.
La lección de fondo: este es el experimento natural más limpio que el mundo open-weights ha entregado este año. Si congelas la arquitectura y solo cambias post-training, cada punto de mejora es atribuible al post-training. Y la conclusión es brutal: el comportamiento agentil se enseña, no se escala con parámetros.
Pesos MIT disponibles en Hugging Face. Pricing: $0.14/$0.28 por millón de tokens input/output.