Mientras el ecosistema se prepara para KubeCon NA de la próxima semana, NVIDIA soltó el 5 de noviembre una pieza que nadie tenía en el radar: NVKE (NVIDIA Kubernetes Engine), publicado en GitHub (dsx-ai-factory/nvke) bajo Apache 2.0 en versión preview v0.24.0-rc.5. La idea: que operadores de datacenters GPU —piensa en los NVIDIA Cloud Partners— puedan ofrecer Kubernetes como servicio administrado sobre su propio bare metal, al estilo de lo que EKS es para AWS, pero dentro de tu propio piso de servidores.
Una fábrica de clusters, no otra distribución
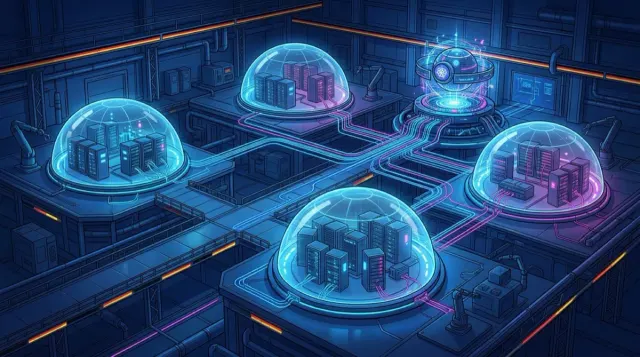
Lo primero que aclara NVIDIA: NVKE no es una distribución de Kubernetes ni una variante de Cluster API. Es una plataforma de control auto-alojada que fabrica clusters completos on-demand. Un management cluster central recibe pedidos vía API y levanta en los servidores bare metal clusters de workload completamente aislados: cada uno con su propia control plane, su propio etcd, sus propios node pools y hasta sus servidores dedicados para la control plane. Cero namespaces compartidos de mentira — aislamiento de verdad, tenant por tenant.
El flujo parte con un seed cluster temporal que arma el management cluster; de ahí en adelante, este crea y administra los clusters de trabajo. Se opera con kubectl estándar de cliente, más el CLI nvkectl y una API REST para pedir clusters con versión de Kubernetes, node pools y configuración de red.
El stack completo de NVIDIA detrás
NVKE no viene solo — viene con la familia entera:
- NICo (NVIDIA Infra Controller) es el único proveedor de infraestructura soportado en la preview: bare metal operado por API en vez de runbooks. Detalle: NICo corre en su propio cluster Kubernetes de al menos 3 nodos, así que en hardware real terminas con dos capas de gestión apiladas.
- Aislamiento de tenants vía BlueField DPUs, las tarjetas de red de NVIDIA con sus propios cores ARM. Alternativa: el provider LaunchLayer instalable por Argo CD desde el ecosistema DSX.
- Identidad anclada en hardware: cada nodo se autentica con SPIFFE/SPIRE + atestación TPM 2.0 antes de recibir credenciales para unirse al cluster, con cifrado de etcd a nivel de cluster.
- Las GPU llegan “peladas”: drivers, container toolkit y device plugin los instala el GPU Operator con recetas de la AI Cluster Runtime (AICR). Las imágenes de nodos las construye el proyecto hermano NVKR (NVIDIA Kubernetes Recipes).
En red, ovn-kubernetes es el CNI por defecto para clusters nuevos (Calico queda solo para instalaciones existentes), y la HA de la API depende de una VIP que kube-vip se encarga de levantar. El código compila nueve binarios —incluidos agent, nvkectl, management-engine y tenant-api— con Go 1.27.3.
Las arrugas de la preview (y hay varias)
NVIDIA es explícito: nada de producción todavía. Y el detalle fino deja claro por qué:
- La API habla HTTP plano sin TLS en el puerto 30080 después de instalar; el endpoint de TLS hay que ponerlo delante uno mismo.
- La autenticación viene apagada por defecto, y aunque actives JWT contra tu Identity Provider, no hay RBAC: cualquiera autenticado puede crear y borrar todos los clusters de workload.
- El management cluster no se auto-escala, no se auto-actualiza, no se auto-reemplaza; y no hay procedimiento de upgrade entre versiones de NVKE ni backup/restore del management plane en esta preview.
Para probar sin datacenter hay un quickstart local con un mock-NICo que levanta cada nodo como contenedor Docker: un host Linux con 6 CPUs, 12 GB de RAM, 100 GB de disco y soporte de vTPM alcanza (en macOS, vía Colima).
Por qué importa
El concepto no es nuevo — Gardener y Kamaji ya operan control planes de clientes como pods en un cluster central — pero el movimiento sí: NVIDIA sigue verticalizando su stack (chips → DGX → DSX → NICo → ahora Kubernetes) y ahora apunta a quedarse con la capa de orquestación completa de los AI factories, no solo el software de IA que corre encima. Con OpenShell recién arrivado a la CNCF y este lanzamiento en la víspera de KubeCon, el mensaje es directo: si tu negocio es alquilar GPU, NVIDIA quiere venderte también la fábrica de clusters donde se consumen.
Fuentes: heise online, BornCity, GitHub dsx-ai-factory/nvke