Los traces distribuidos responden bien una pregunta: ¿dónde se fue el tiempo entre mis servicios?. Pero apenas el trace apunta a un span lento, aparece la pregunta que de verdad duele: ¿qué pasó adentro del código durante ese span?. Esa brecha es la que convierte una investigación prometedora en un paseo eterno entre AppOps y desarrollo. Splunk salió a cerrarla con Call Graph Profiling en Splunk APM.
Tracing muestra dónde, el call graph muestra qué pasó adentro
Un trace sigue el request mientras viaja por los servicios: dependencias, timing de spans, errores, y en qué parte de la transacción aparece la latencia. Contexto esencial, sí, pero un span representa una unidad de trabajo, no cada método que la ejecutó.
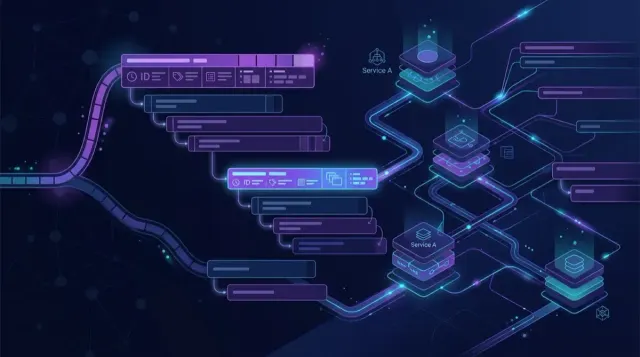
El call graph va más profundo. Visualiza la jerarquía de llamadas a métodos dentro de un trace, incluyendo duración total, duración por método, hora de inicio y exit calls. La gracia: todo ese contexto a nivel de código queda conectado al trace que gatilló la investigación, sin que tengas que cambiar de herramienta.
- Tracing reduce el problema a un servicio, endpoint o span.
- Call Graph Profiling expone la secuencia y jerarquía de métodos dentro de esa ejecución.
- Juntos conectan el comportamiento de la aplicación con el comportamiento del código.
La estrella: el self-time
El detalle que separa a los que entienden de los que solo miran gráficos bonitos es el self-time: la duración total de un método menos la duración de sus métodos hijos. Un método padre puede verse caro solo porque espera a que sus hijos terminen; un método con self-time alto está gastando el tiempo en su propio trabajo. Splunk APM muestra el summary bar con los métodos con mayor self-time y deja resaltar los métodos y filas correspondientes.
Esto le da a ops y desarrollo un cuerpo de evidencia compartido: la transacción de negocio afectada, el trace y span donde ocurrió la latencia, la jerarquía de métodos, la duración y porcentaje del call-stack por método, y el exit call o thread que sigue el camino.
Cómo complementa a AlwaysOn Profiling
No es un reemplazo, es un complemento. AlwaysOn Profiling recolecta stack traces en continuo y usa flame graphs para entender el comportamiento de CPU y memoria a lo largo del tiempo. Call Graph Profiling entrega un call graph detallado para traces seleccionados, ideal cuando la investigación parte de un request lento o fallido puntual. Ojo con el modelo de licencia: Call Graph Profiling requiere licencia de AlwaysOn Profiling, y el call graph como parte del always-on profiling pide licenciamiento Enterprise.
Lo que puedes pillar con un call graph
- Métodos de alta latencia: el summary de self-time distingue a los que hacen trabajo de verdad de los que solo acumulan tiempo por sus descendientes.
- Caminos de código ineficientes: llamadas redundantes, repeticiones evitables o ramas de ejecución inesperadas.
- Operaciones intensivas en latencia: serialización, transformación de datos, acceso a archivos, o llamadas que salen del contexto actual (los exit-call links te dejan seguir el hilo cuando el trabajo cruza de servicio o de thread).
- Errores y excepciones: contexto a nivel de código para conectar un request fallido con los métodos y líneas probables.
Un flujo de investigación más limpio
Parte por el impacto de negocio → identifica el span problemático → abre el call graph asociado → revisa el self-time primero → inspecciona la jerarquía → sigue los exit calls cuando el trabajo cruza una frontera → comparte evidencia (copias nombres de métodos o descargas el call graph como JSON) → valida el fix comparando latencia y evidencia de profiling.
Para arrancar
Disponible en Splunk Observability Cloud. Requiere Splunk APM, licencia de AlwaysOn Profiling, instrumentación OpenTelemetry de Splunk soportada y un Splunk Distribution of the OpenTelemetry Collector compatible. Soporte para Java, .NET, Node.js y Python.
Un aviso sano: el profiling agrega trabajo de runtime, y muestrear más seguido sube el uso de CPU y memoria. La probabilidad de selección por defecto es 0.01 y se puede subir hasta 0.1. Prueba en staging, mide el overhead y afina antes de tirarlo a producción.
El takeaway
Lo más difícil de troubleshootear casi nunca es detectar el problema, sino pasar de una señal amplia a evidencia lo bastante específica para que alguien actúe. Call Graph Profiling acorta ese camino: conecta traces distribuidos con los métodos ejecutados dentro de un request, expone dónde se va el tiempo y conserva la jerarquía para entender el porqué. Para ops, un handoff más preciso; para desarrollo, menos tiempo reproduciendo síntomas y más tiempo arreglando el código que importa.
Fuente: Splunk Blog (27-08-2026).