Un fleet de agentes puede generar una factura al centavo sin mostrar si el gasto compró trabajo útil. La factura muestra cuánto gastaste; esconde si sirvió para algo. Splunk salió con un post que da en el clavo: nos volvimos buenísimos para medir tokens, y pésimos para medir valor.
La paradoja incómoda
Los precios por token cayeron más de 90% desde 2023. GPT-4 debutó en marzo de 2023 a US$30 por millón de tokens de input y US$60 por millón de output. Para abril de 2026, los modelos Google Gemini Flash/Lite ya estaban alrededor de US$0.10 por millón de input — casi 99.7% más barato que GPT-4.
¿Y? Si la inteligencia se está colapsando hacia lo gratis, ¿por qué la cuenta de IA de todos sigue subiendo?
El costo por token te dice lo que pagaste, no lo que obtuviste
Dos modelos responden el mismo problema difícil y ambos aciertan. La investigación de OckBench encontró que dos modelos con la misma accuracy pueden diferir en 25× en tokens generados: uno responde en ~1.600 tokens y otro gasta 42.000. Mismo resultado, 25 veces el output facturable. Si mides solo accuracy, los modelos se ven idénticos; si mides cuánto cuesta lograr ese resultado correcto, la diferencia es el juego completo.
Tres fuerzas rompieron el vínculo entre tokens y valor, todas a la vez:
- Los reasoning models movieron el costo del input al output. Los reasoning tokens de OpenAI, los extended thinking de Anthropic y los thought tokens de Gemini se facturan como output (más caro) y pueden no coincidir con la respuesta visible. En siete benchmarks, OpenAI o1 generó más de 44 millones de tokens donde GPT-4o produjo ~5.5 millones: ~8× para el mismo set.
- Prompts más chicos ya no son siempre más baratos, por el caching. El costo por request ahora depende más del estado del caché que del largo del prompt.
- El consumo explotó. Google procesa 3.2 cuatrillones de tokens al mes, arriba de 9.7 billones hace dos años. Precios bajando + consumo disparándose: bucles de reasoning más profundos y flujos multi-agente multiplican tokens por tarea más rápido de lo que baja el precio. Un paper de enero de 2026 lo formalizó como la Paradoja de Jevons Estructural.
Cómo funciona el costo por resultado
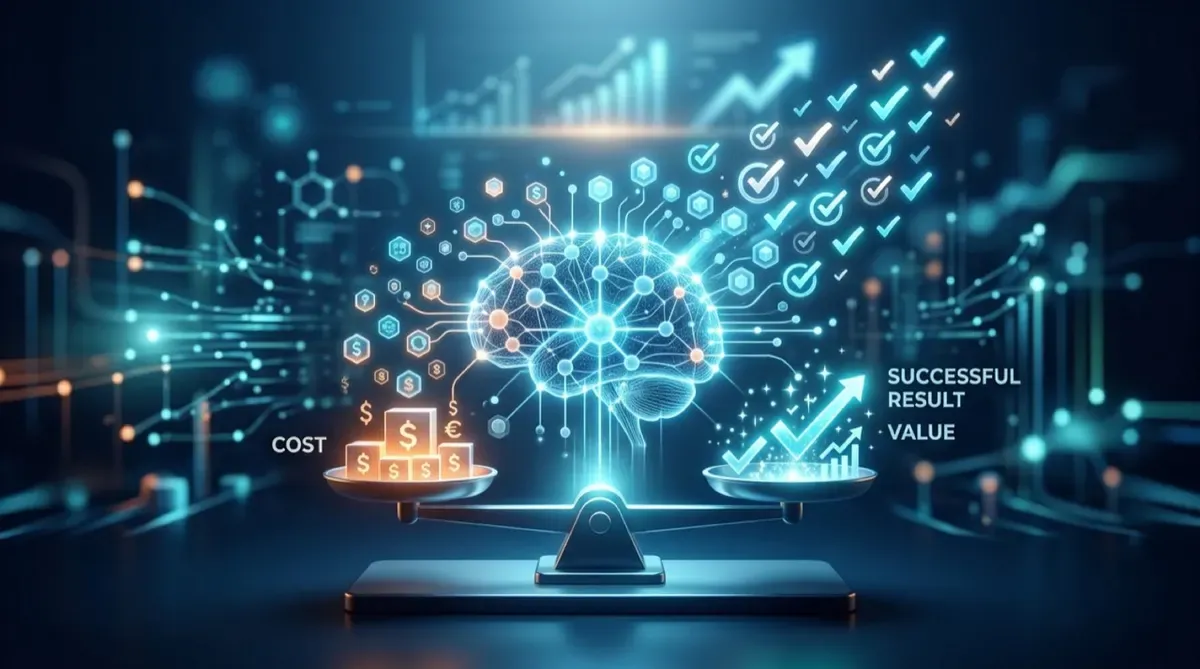
El costo efectivo se define como costo por intento dividido por la tasa de resolución. Pagas por diez intentos, aciertas dos, y el costo real es cinco veces el precio de lista. La métrica correcta es el costo esperado por tarea exitosa.
Un modelo más caro por token pero que acierta a la primera puede salir más barato por resultado que uno “barato” que patalea. Por eso la disciplina se está formalizando: el 3 de junio de 2026, la Linux Foundation anunció su intención de lanzar la Tokenomics Foundation para construir estándares abiertos de gestión de costos de IA, al lado de FinOps.
Todavía no tenemos el denominador
El costo es fácil; el resultado es el problema abierto. No hay ground truth para la calidad subjetiva (utilidad, tono, pertinencia dependen de los objetivos y el apetito de riesgo del usuario). Entonces hacemos proxy, y cada proxy tiene un tradeoff:
- Evaluación humana: correlación perfecta por definición, pero cuesta más de US$1.000 por cada mil evaluaciones y toma días.
- LLM-as-judge: más barato y rápido, con correlación 0.70–0.85.
- Más barato que eso y la correlación se cae por un barranco.
Los proxies tienen sus propios modos de falla: el efecto rubber-stamp (humanos tienden a aprobar la respuesta del modelo aunque esté demostrablemente mal) y los test sets curados no garantizan rendimiento en producción. Traducción: si alguien te dice que ya resolvió el costo por resultado, desconfía. La matemática existe, pero el estándar de producción aún no.
Por qué vale la pena pelearla
La alternativa ya es visible e inexcusable: gasto que no podemos justificar ni defender. Goldman Sachs calculó que unos US$700 mil millones de inversión en IA en 2025 aportaron esencialmente cero al crecimiento del PIB de EE.UU., y el MIT encontró 95% reportando retorno cero en pilotos de IA. Esos no son números de un campo que sabe qué compra su plata.
Cuando el resultado se puede medir, se puede actuar. El routing basado en evidencia ya funciona: RouteLLM logró 85% de reducción de costo manteniendo 95% de la calidad de GPT-4 mandando solo el 14% de las consultas difíciles al modelo fuerte. Un sistema de tutoría de IA mantuvo 97.1% de la calidad premium con 71.6% menos costo escalando solo el 18% de las consultas. Esas decisiones son imposibles mirando solo conteo de tokens.
El takeaway
El costo por token es el número ubicuo; el costo por resultado es el número que necesitas. Los equipos que ganen los próximos años van a ser los que construyan un denominador específico que refleje qué significa “suficientemente bueno” para su trabajo, lo instrumenten a lo largo del tráfico y argumenten costo contra calidad con números en vez de corazonadas. Ese es el problema abierto, y es el que vale la pena resolver.
Fuente: Splunk Blog (27-08-2026).