Si creías que el cuello de botella en AI eran las GPUs, WEKA acaba de recordarte que el storage y la memoria son los que realmente dictan el costo por token. Ayer lanzaron dos productos conectados que cambian la conversación.
NeuralMesh 6: el release más grande en la historia de WEKA
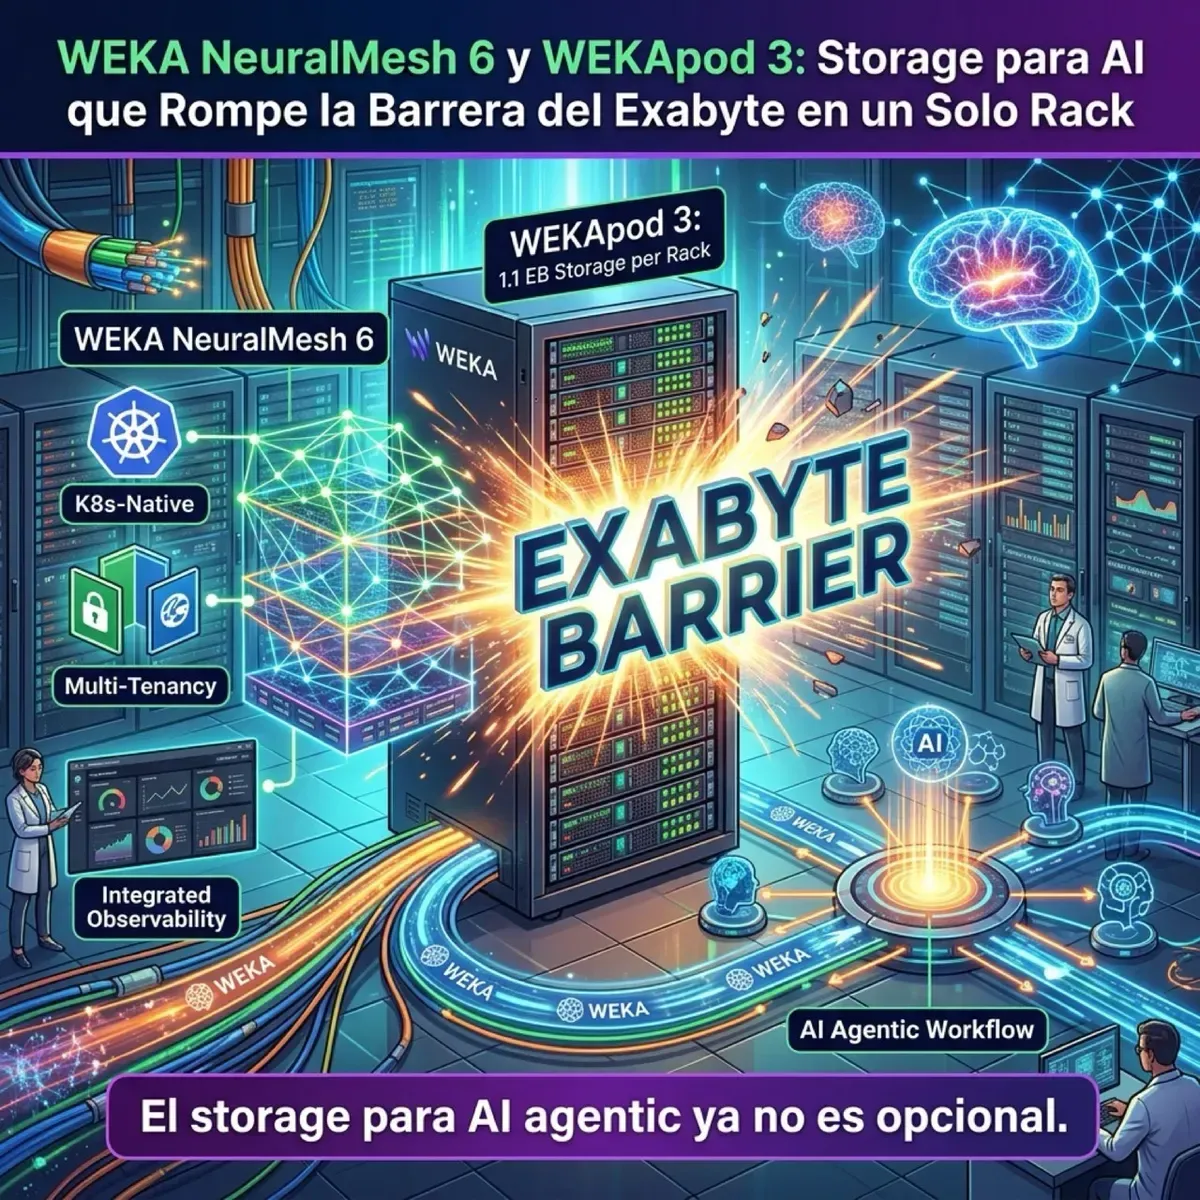
No es marketing — es la descripción literal de la compañía. NeuralMesh 6 trae features que tradicionalmente los operadores de infra AI tenían que armar desde distintos vendors:
- Multi-tenancy nativa con dos niveles: Composable Clusters (aislamiento a nivel hardware, CPU/memoria/storage dedicado por tenant) y Virtual Multi-Tenancy (aislamiento estilo VPC con VLANs privadas, overlapping IP, QoS por tenant)
- Stack de protocolos unificado file-and-object construido sobre NVMe
- Movilidad de datos inteligente con replicación y caching remoto
- Data reduction always-on con garantías de performance contractuales
- Operaciones Kubernetes-native — se maneja como cualquier workload K8s
- Observabilidad integrada — no necesitas pegar Datadog/Grafana encima para ver qué pasa
La economía de inferencia es el punto. Cuando los workloads pasan de training a inferencia agentic de largo contexto, la capa de storage determina cuántos tokens por segundo puedes sostener y a qué costo.
WEKApod 3: un exabyte en un rack
Si NeuralMesh 6 es el software, WEKApod 3 es el hardware que lo corre. Y los números son bestiales:
- 1.1 EB (exabytes) de capacidad en un solo rack — la barrera del exabyte en single-rack, oficialmente rota
- Tres configuraciones: Nitro (máximo performance), Prime (capacidad balanceada), Prime Max (máxima densidad)
- Diseñado y manufacturado por WEKA, con NeuralMesh 6 preinstalado
Para contexto: Cast AI reportó en su 2026 State of Kubernetes Optimization Report que la utilización promedio de GPU en clusters enterprise es de solo 5%. Parte de eso es overprovisioning, pero parte es que los workloads no tienen data listo cuando la GPU lo pide. WEKApod ataca ese problema desde el lado del storage.
Disponibilidad
NeuralMesh 6 estará GA en la segunda mitad de 2026. Los clientes existentes de WEKA pueden upgradar gratis. WEKApod 3 ya se está entregando.
💡 El dato: GPU utilization promedio en enterprise K8s es 5%. Si tu storage no entrega data a la velocidad correcta, tienes GPUs carísimas esperando. Ese es el problema que WEKA está atacando.